桌面首发 · Lumi / Vesper / Mira
Three minds.
One better decision.
四个页签,一个窗口:对话、轨迹、群聊、评测。Lumi 动手做,Vesper 逐条核验她的主张有没有真凭实据,Mira 把她的方案讲成人话。

桌面首发 · Lumi / Vesper / Mira
四个页签,一个窗口:对话、轨迹、群聊、评测。Lumi 动手做,Vesper 逐条核验她的主张有没有真凭实据,Mira 把她的方案讲成人话。
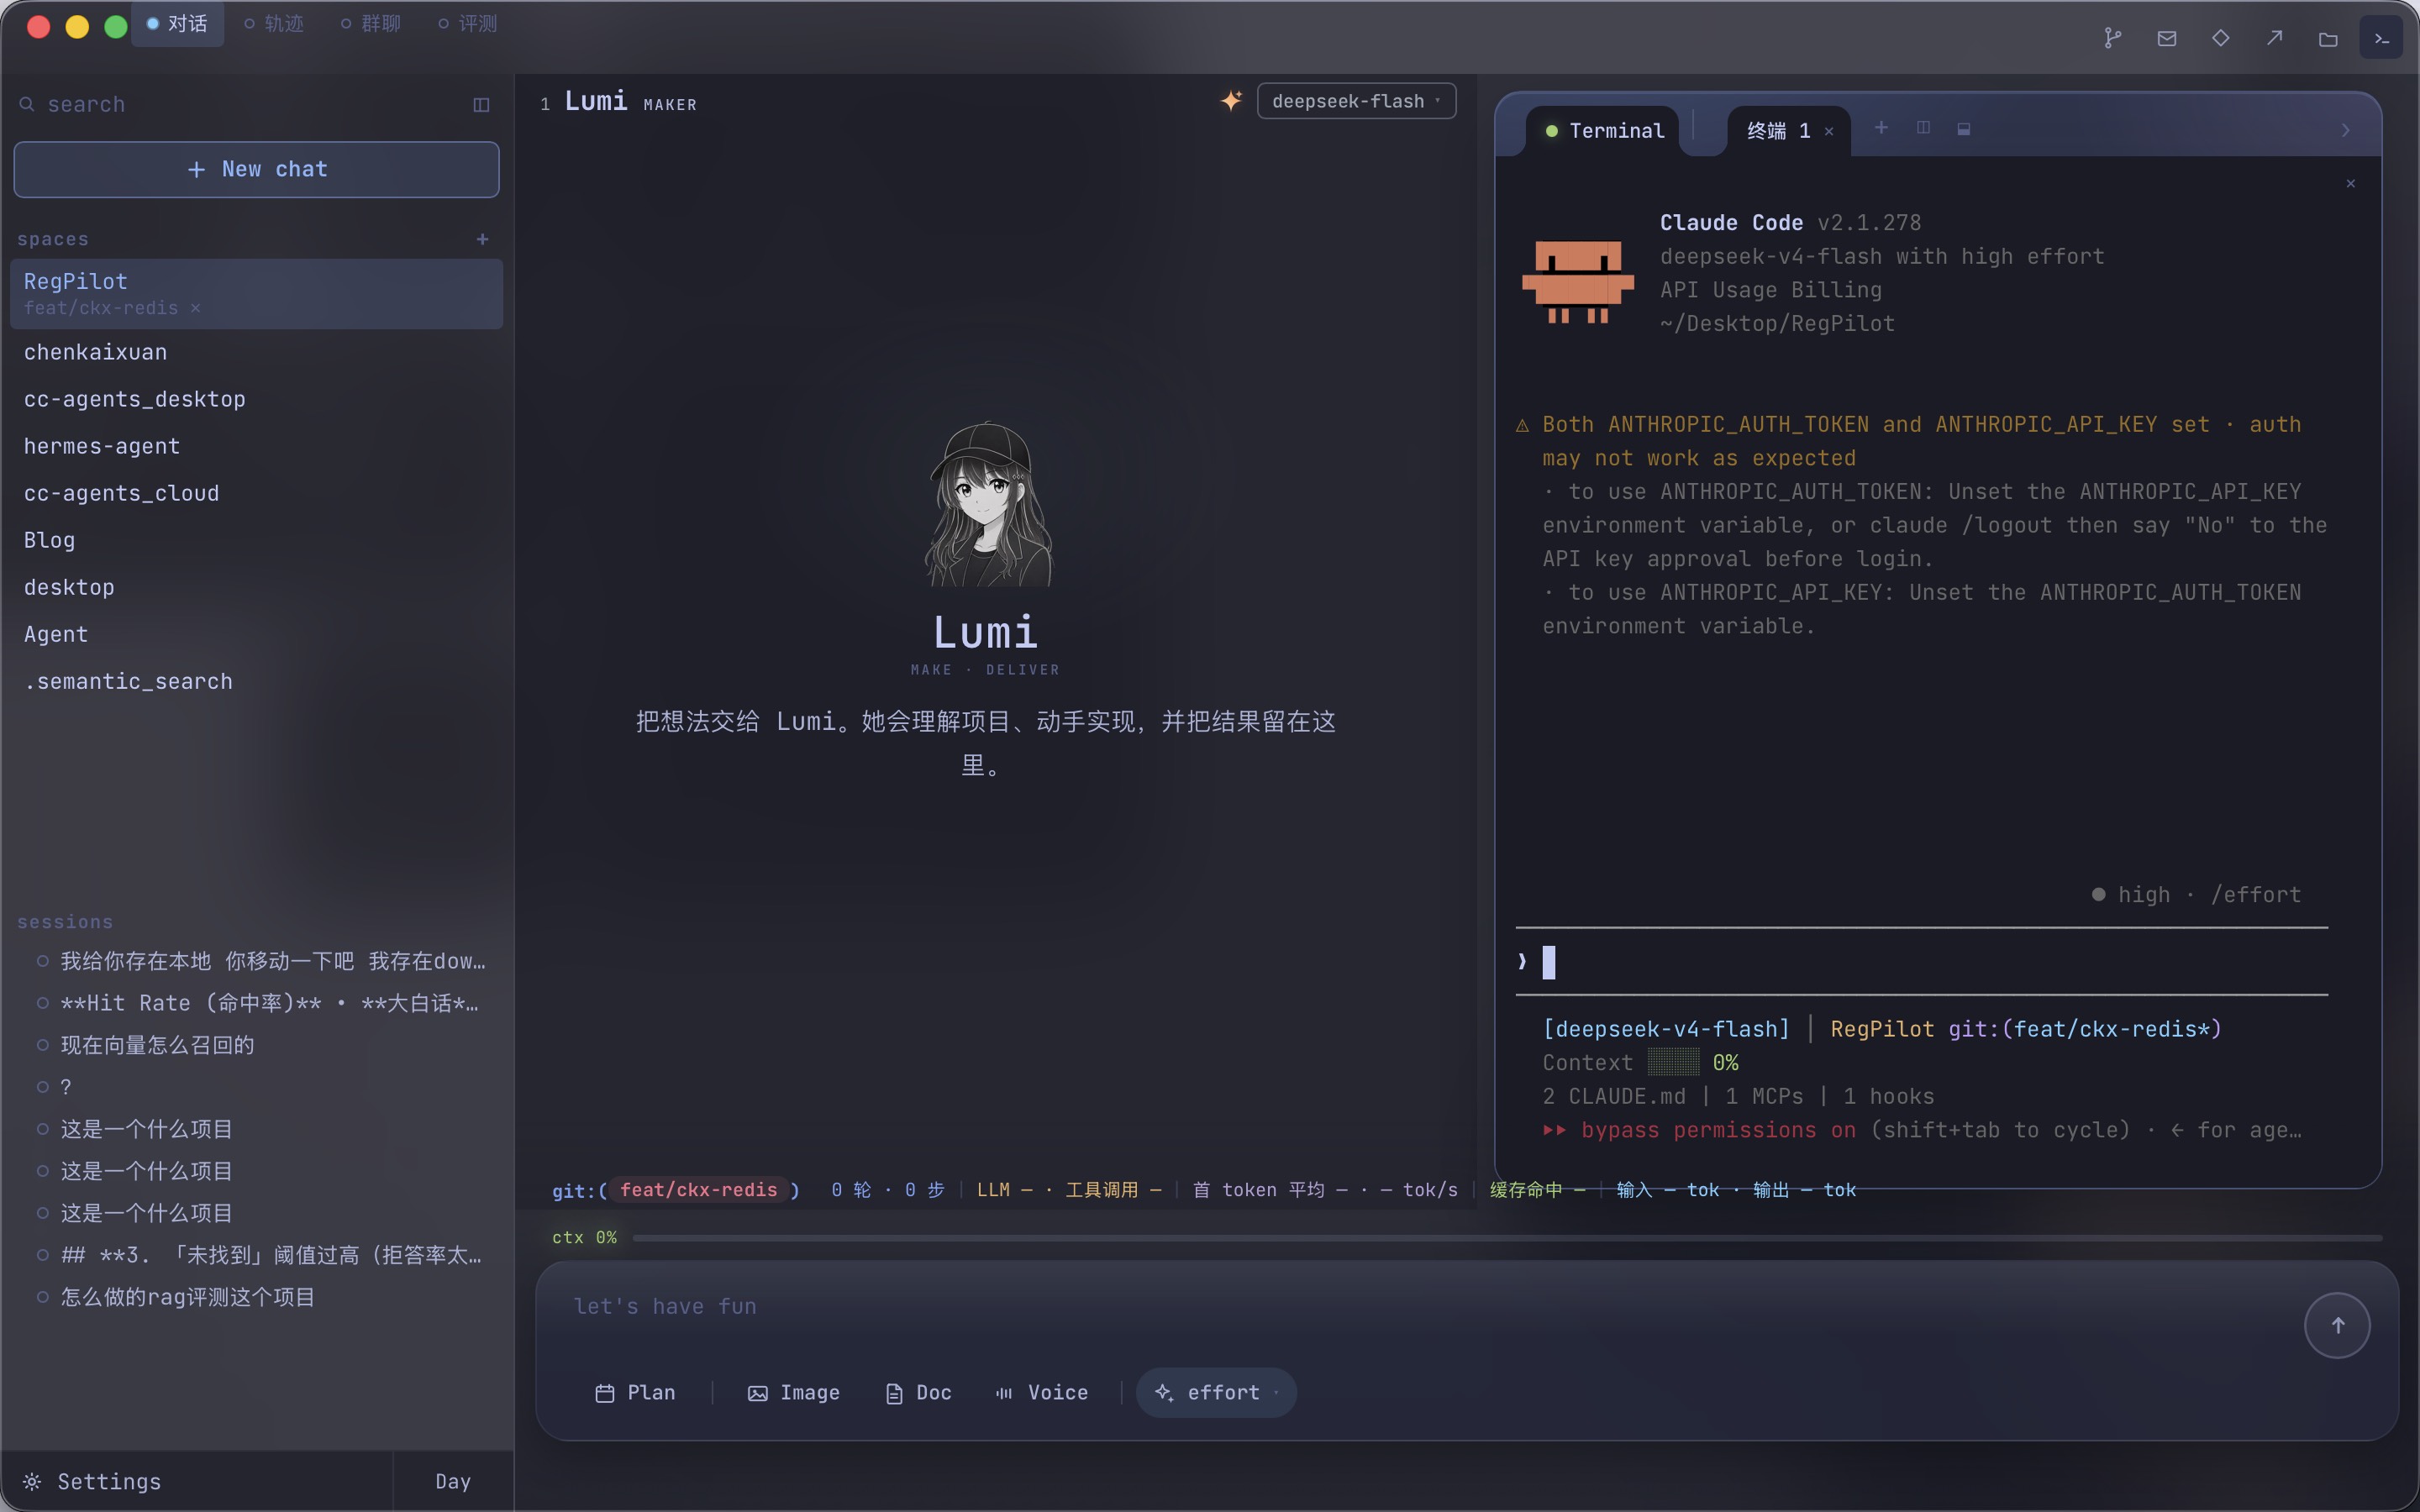
四块地方各干各的:左栏挑项目、翻历史会话,中间跟 Lumi 说需求,右栏是终端面板。输入框上方那行实时写着分支、轮次 / 步数、首 token 延迟和 tok/s,下面一条是 ctx 占用。
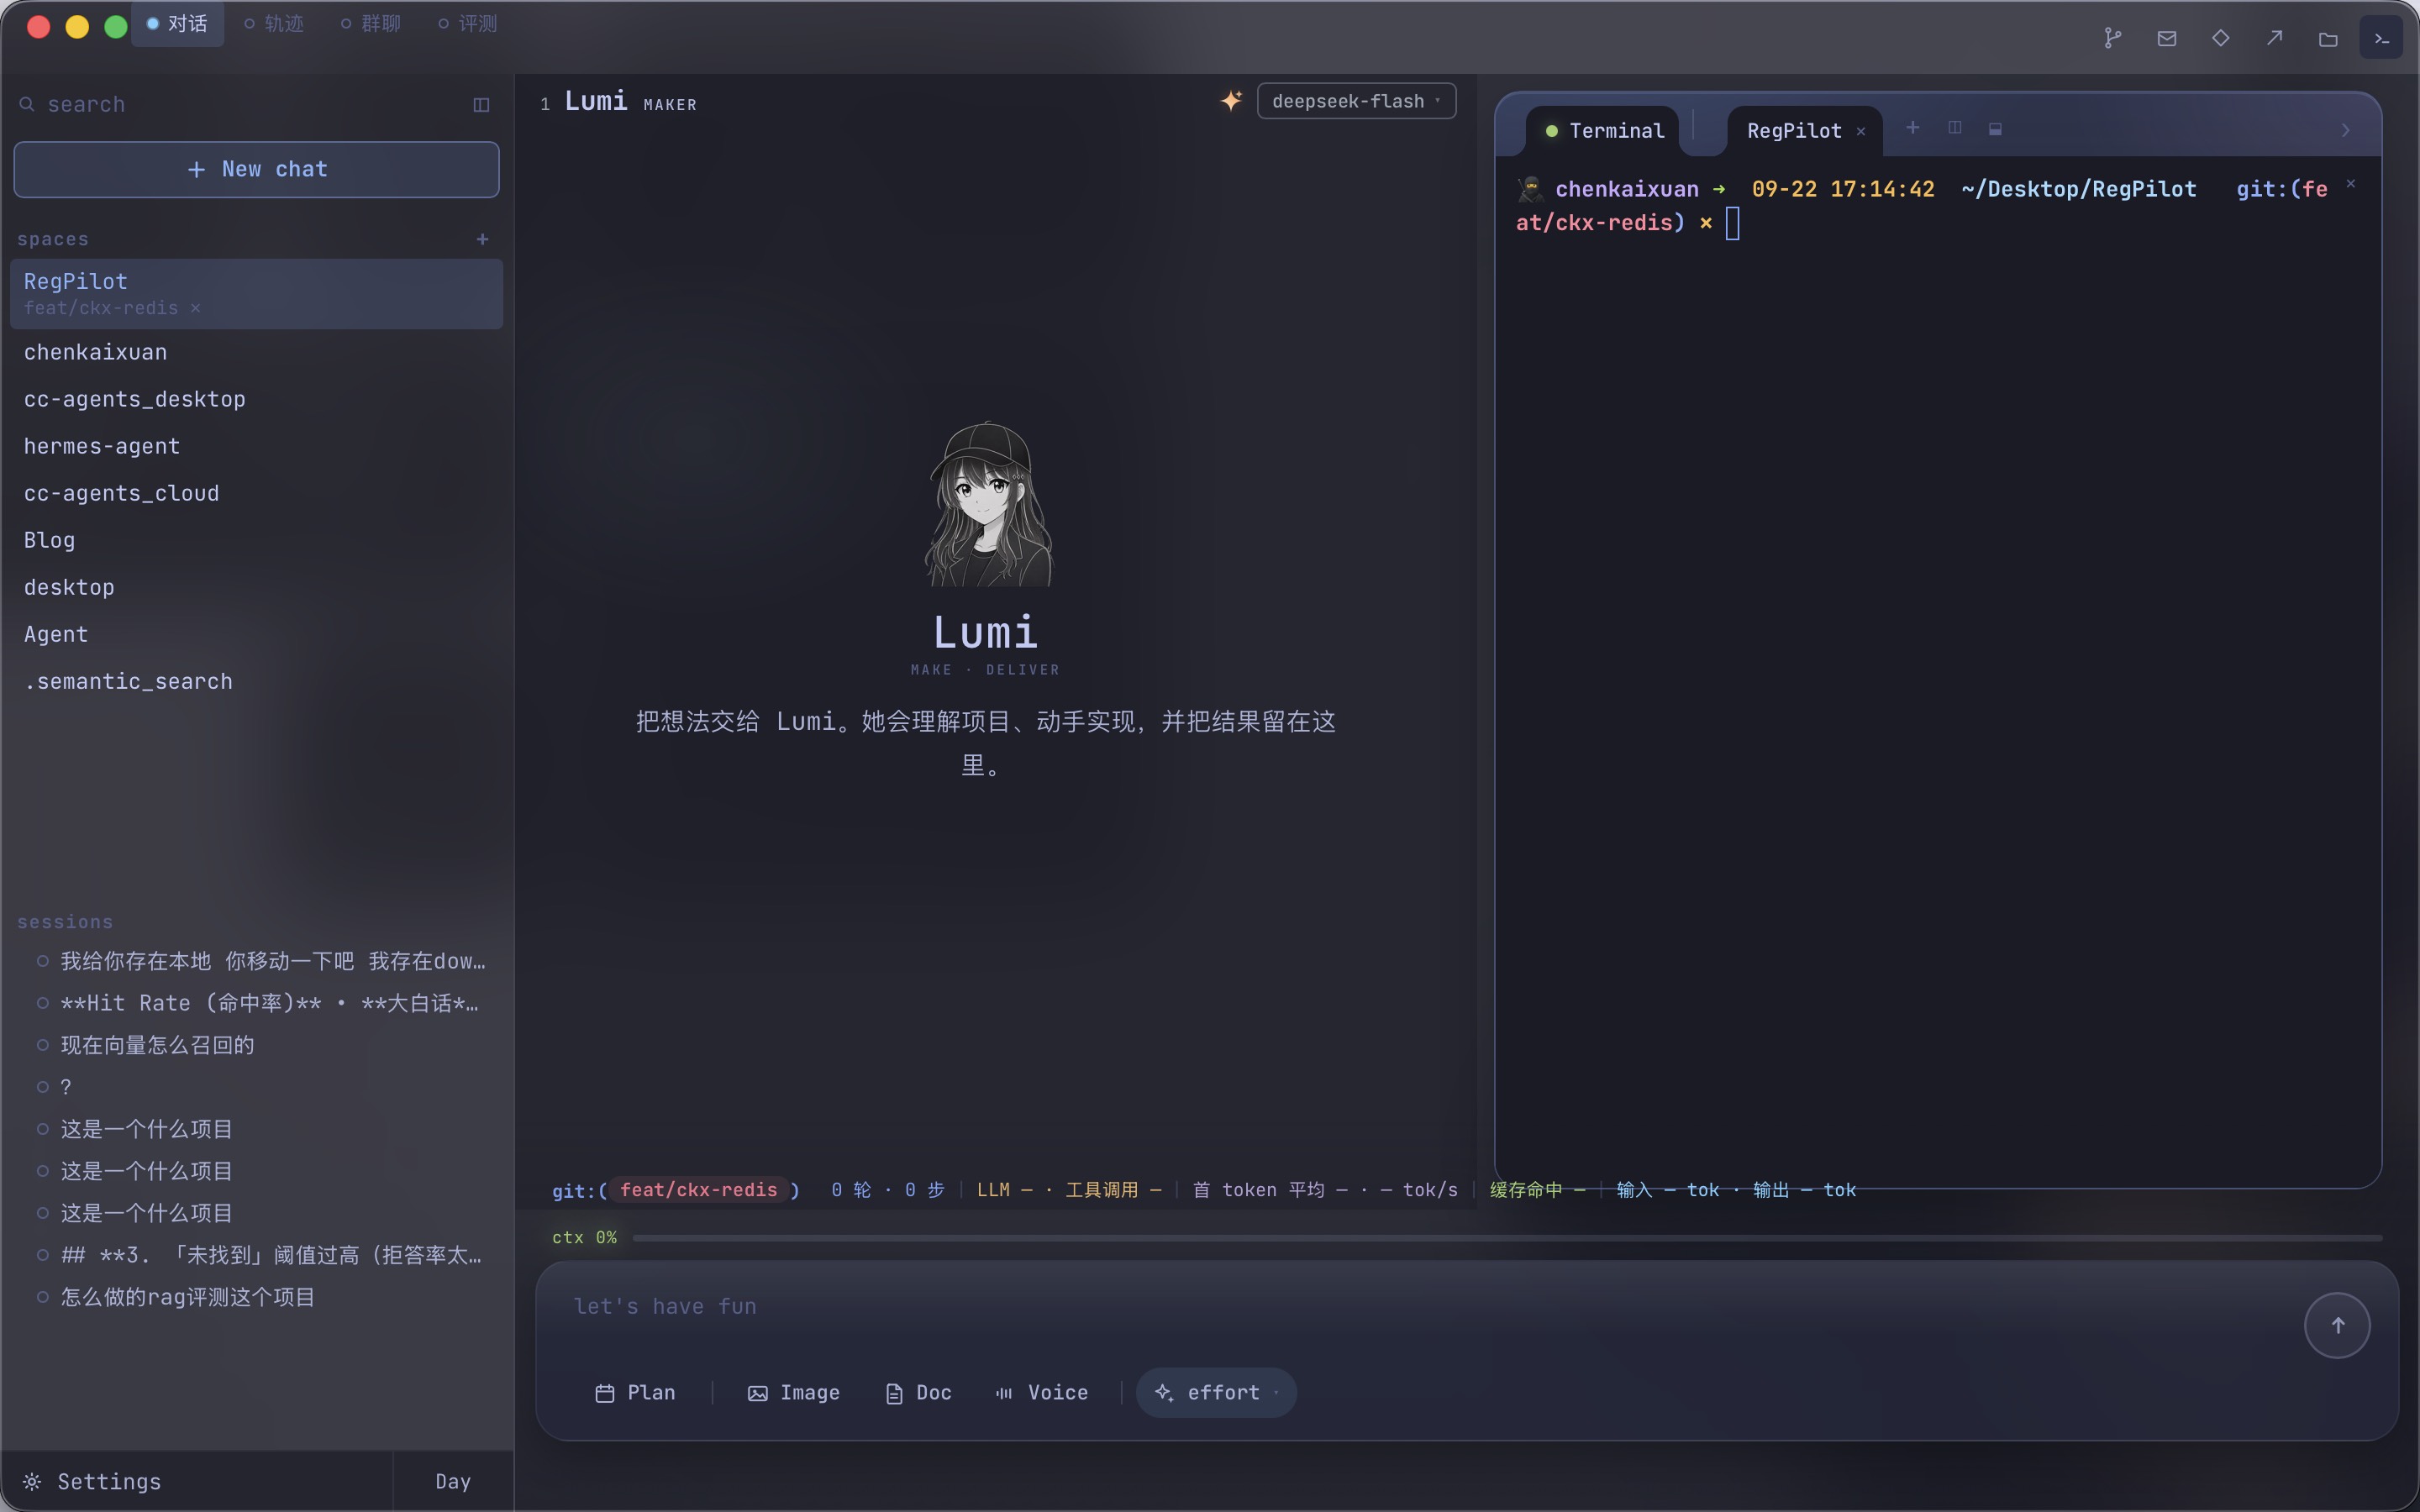
空状态就说了一句话:把想法交给 Lumi,她会理解项目、动手实现,并把结果留在这里。
git:(分支) · 第几轮第几步 · LLM 耗时 · 首 token 平均 · tok/s · 缓存命中,全挤在一行里。
每个 space 底下挂着当前分支(cc-agents_desktop / software-engineering),再往下是全部历史会话,点一条就回去。
对话页 — 左栏项目与会话 · 中间 Lumi · 右栏终端 · 底部实时状态条
群聊页就两张角色卡:Vesper 是审计官,逐条核验主张有没有真凭实据;Mira 是翻译官,把方案讲成人话。每轮还挂着一条「审阅对象」——Round 1 就是你刚说的那句。两位不跟着主线自动跑,只在你点名时开口;群聊输入口现在也还没开放,发送是灰的。
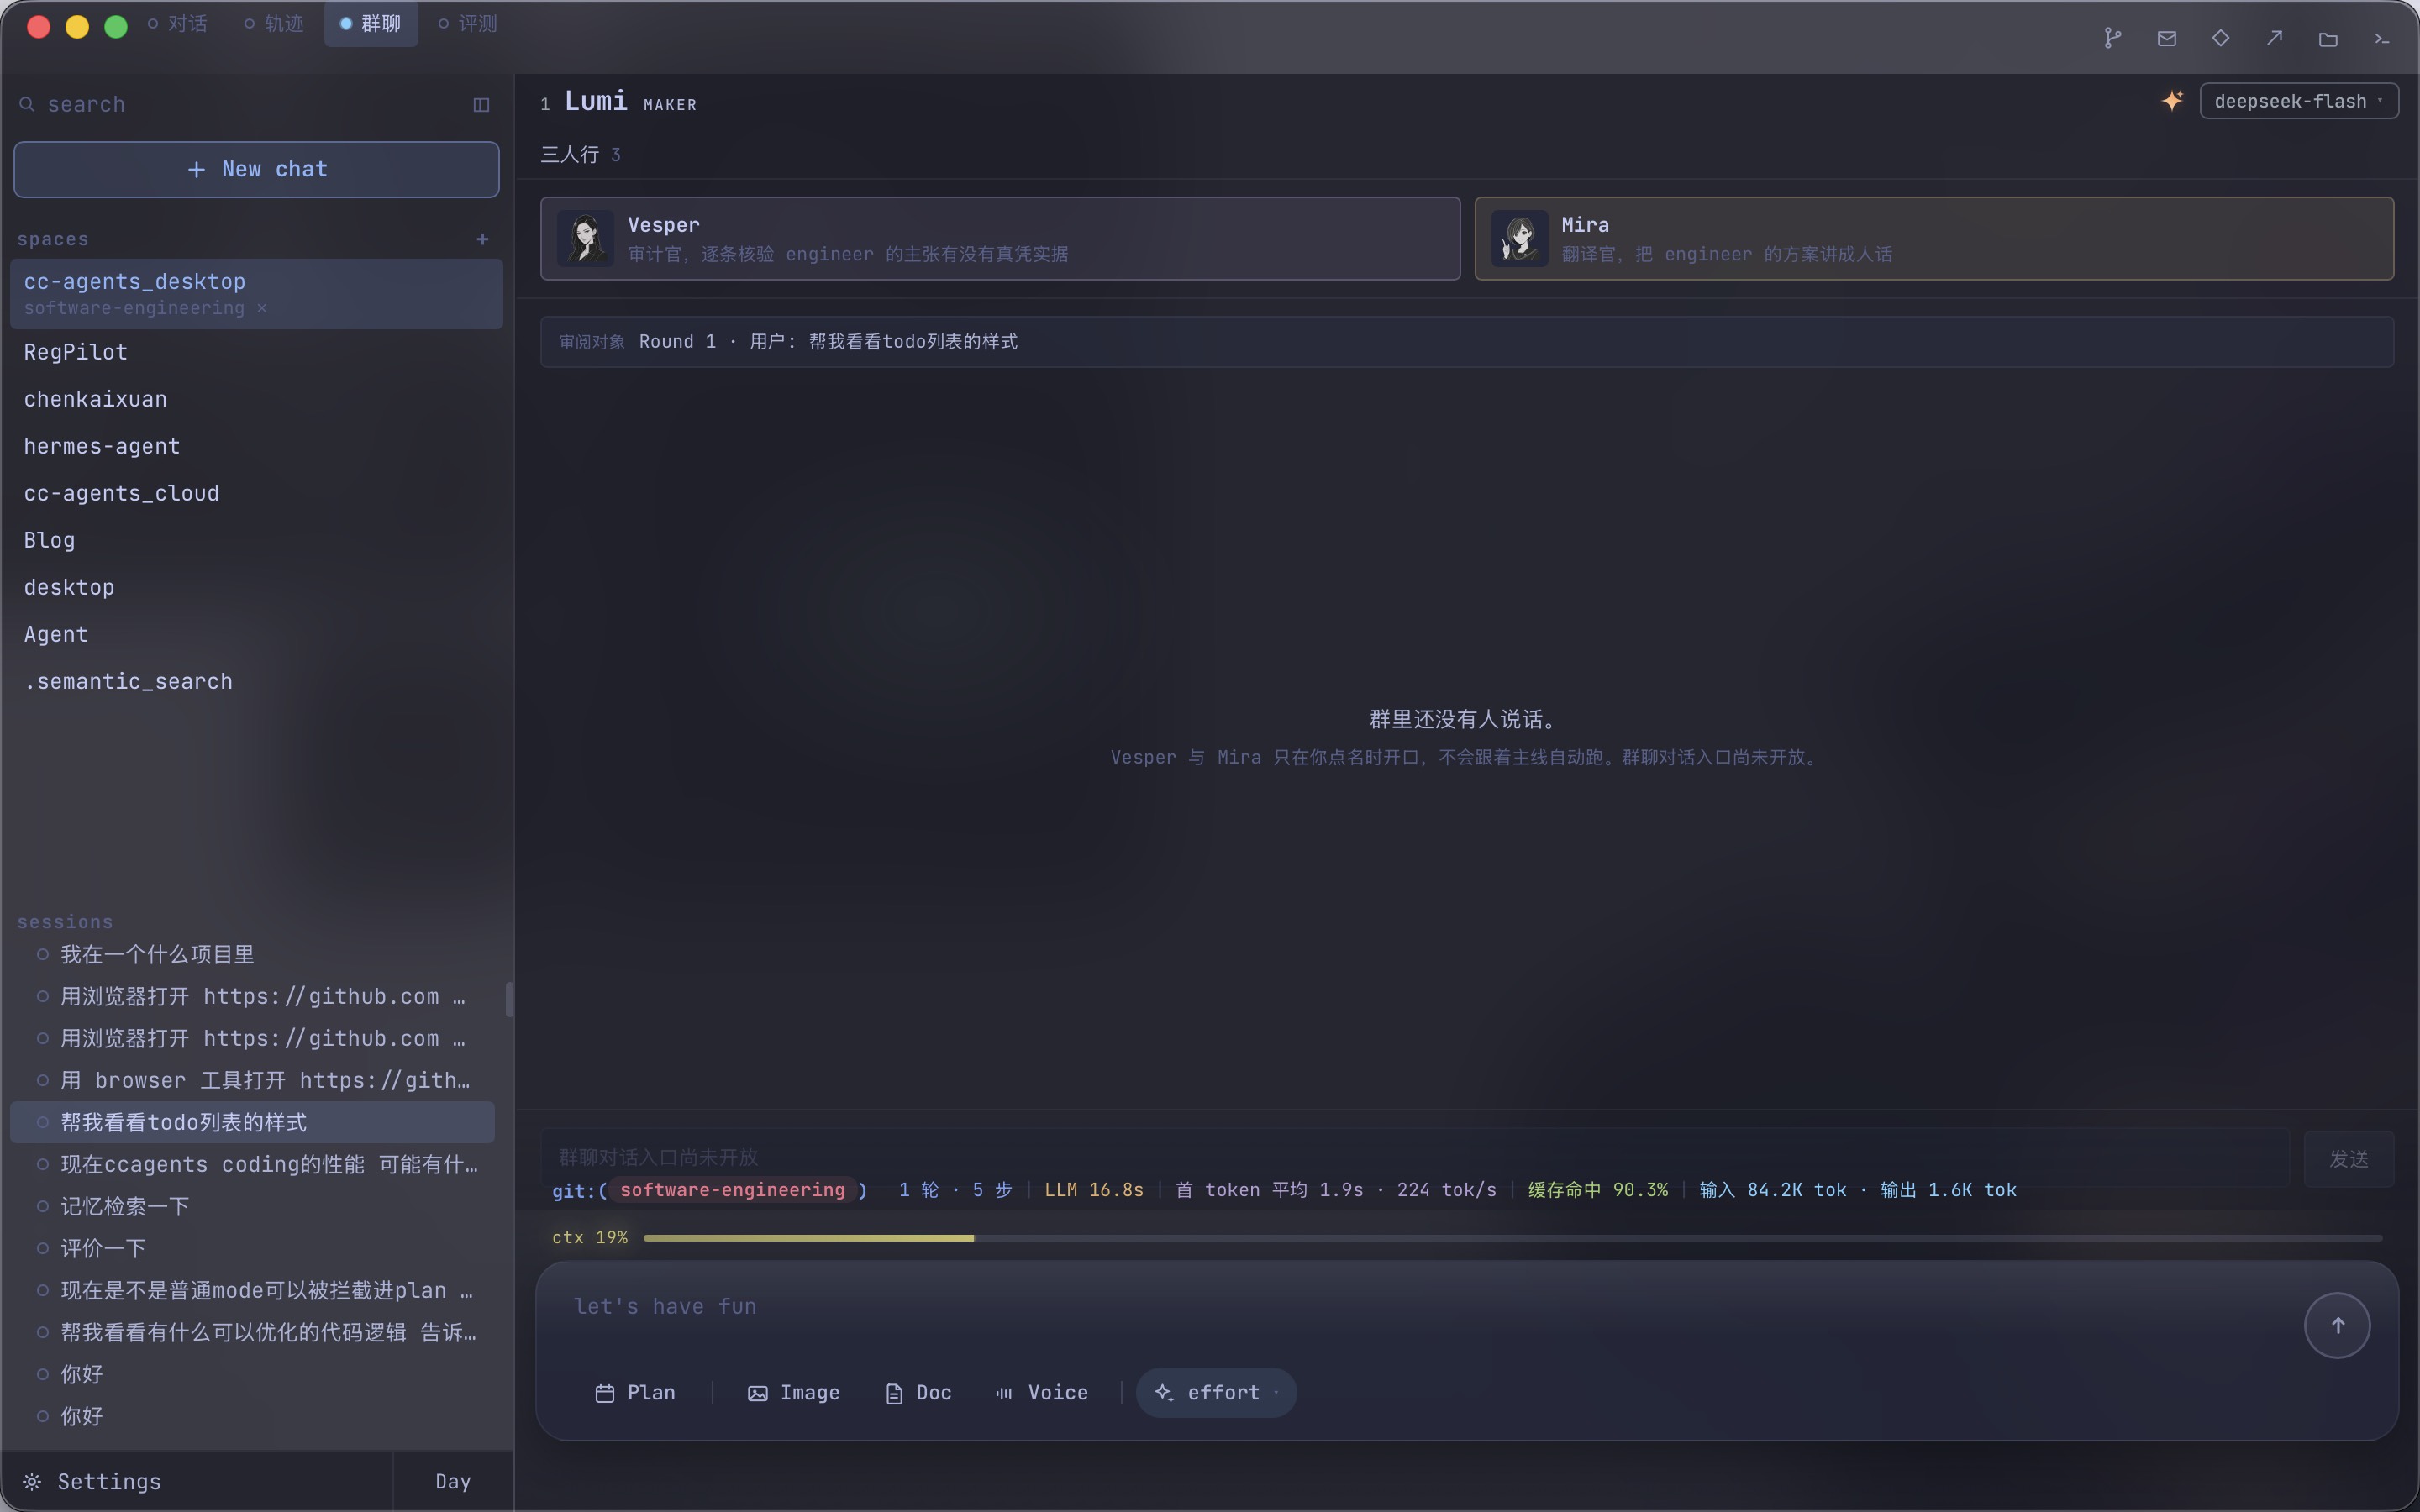
群聊 — 两张角色卡 + 每轮的审阅对象;未点名不出声
轨迹页把一轮摊开给你看:Turn 1 下面从 #1 排到 #9,第一行是你的原话,其余全是 glob、grep、read_file 这类工具调用,参数直接写在行里,右边跟着单次耗时。顶上还能切 Duration / Turns / Calls 三种视图,看时间花在哪、工具调了多少次。
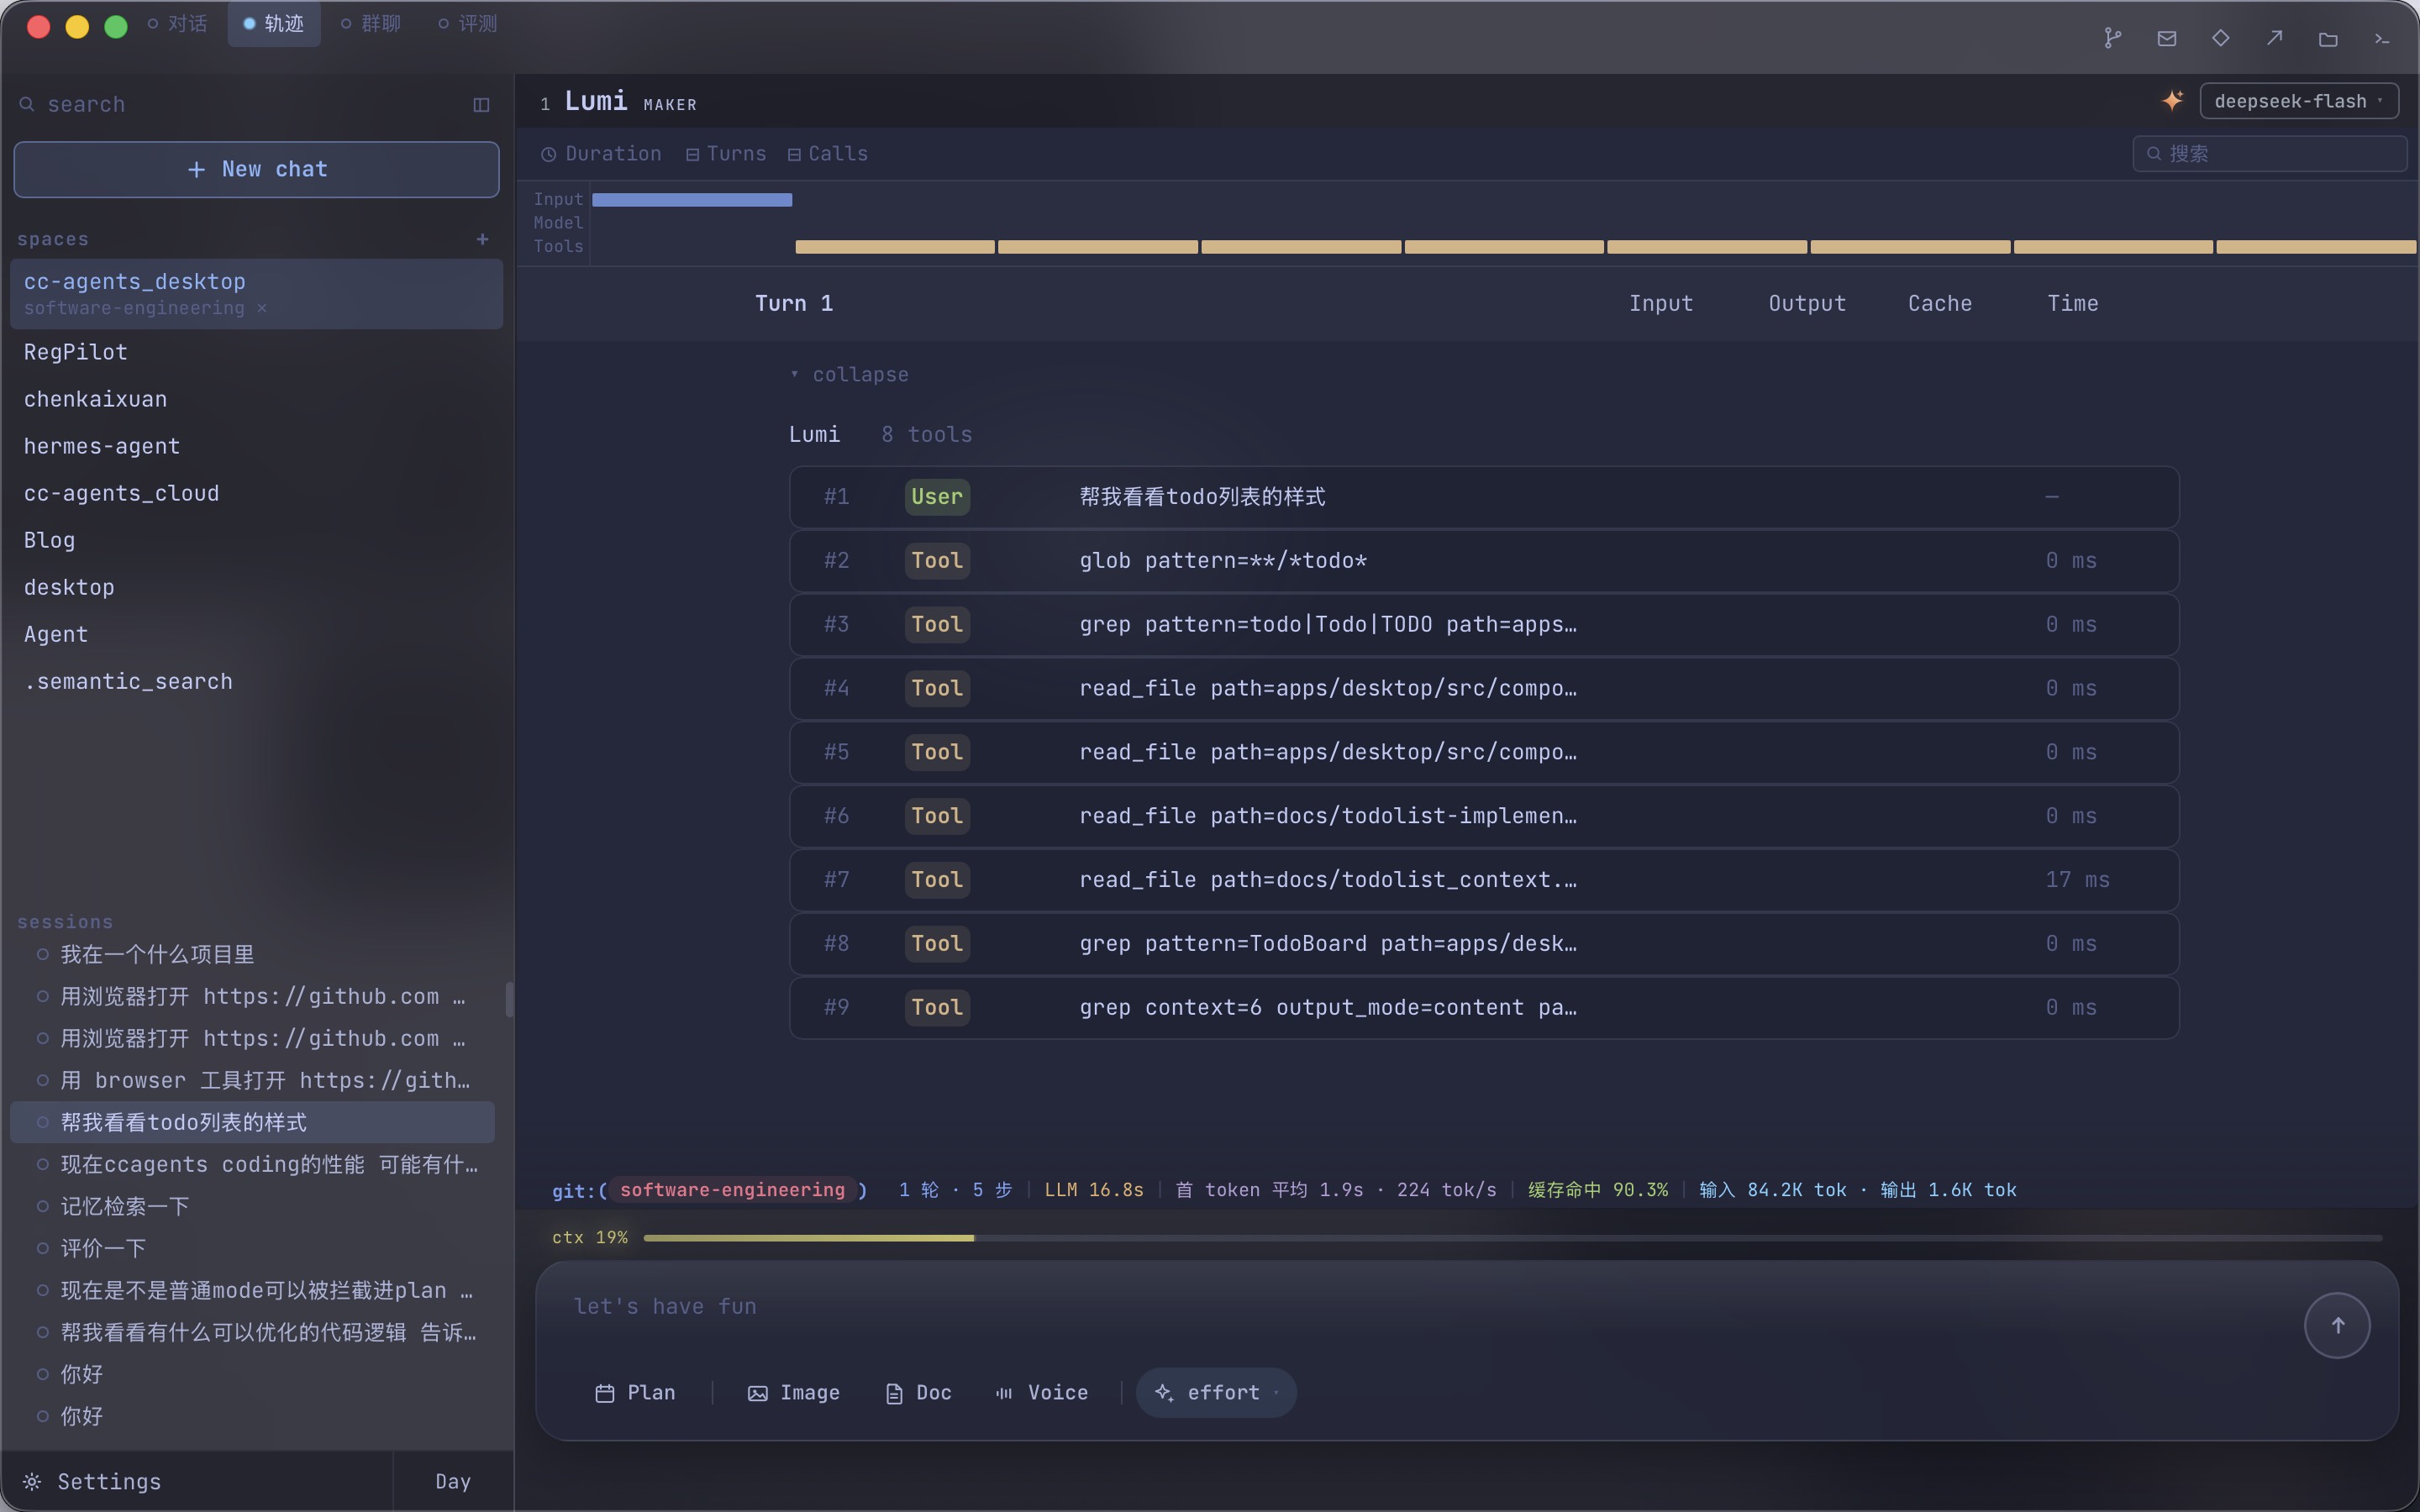
轨迹 — Turn 1:1 条用户消息 + 8 条工具调用,逐行带参数与耗时
右侧面板是个真终端:「+」菜单里就两项——终端和 Browser,Browser 每个标签各自 start / stop 一个 browser session。终端归项目不归会话,切走再回来它还在。你自己的命令、外部的 CLI agent 都跑在这一个面板里;状态行那几个数字(模型、ctx、CLAUDE.md、MCP、hooks)是终端里那个 CLI 自己报的,不是 cc-agents 的功能。
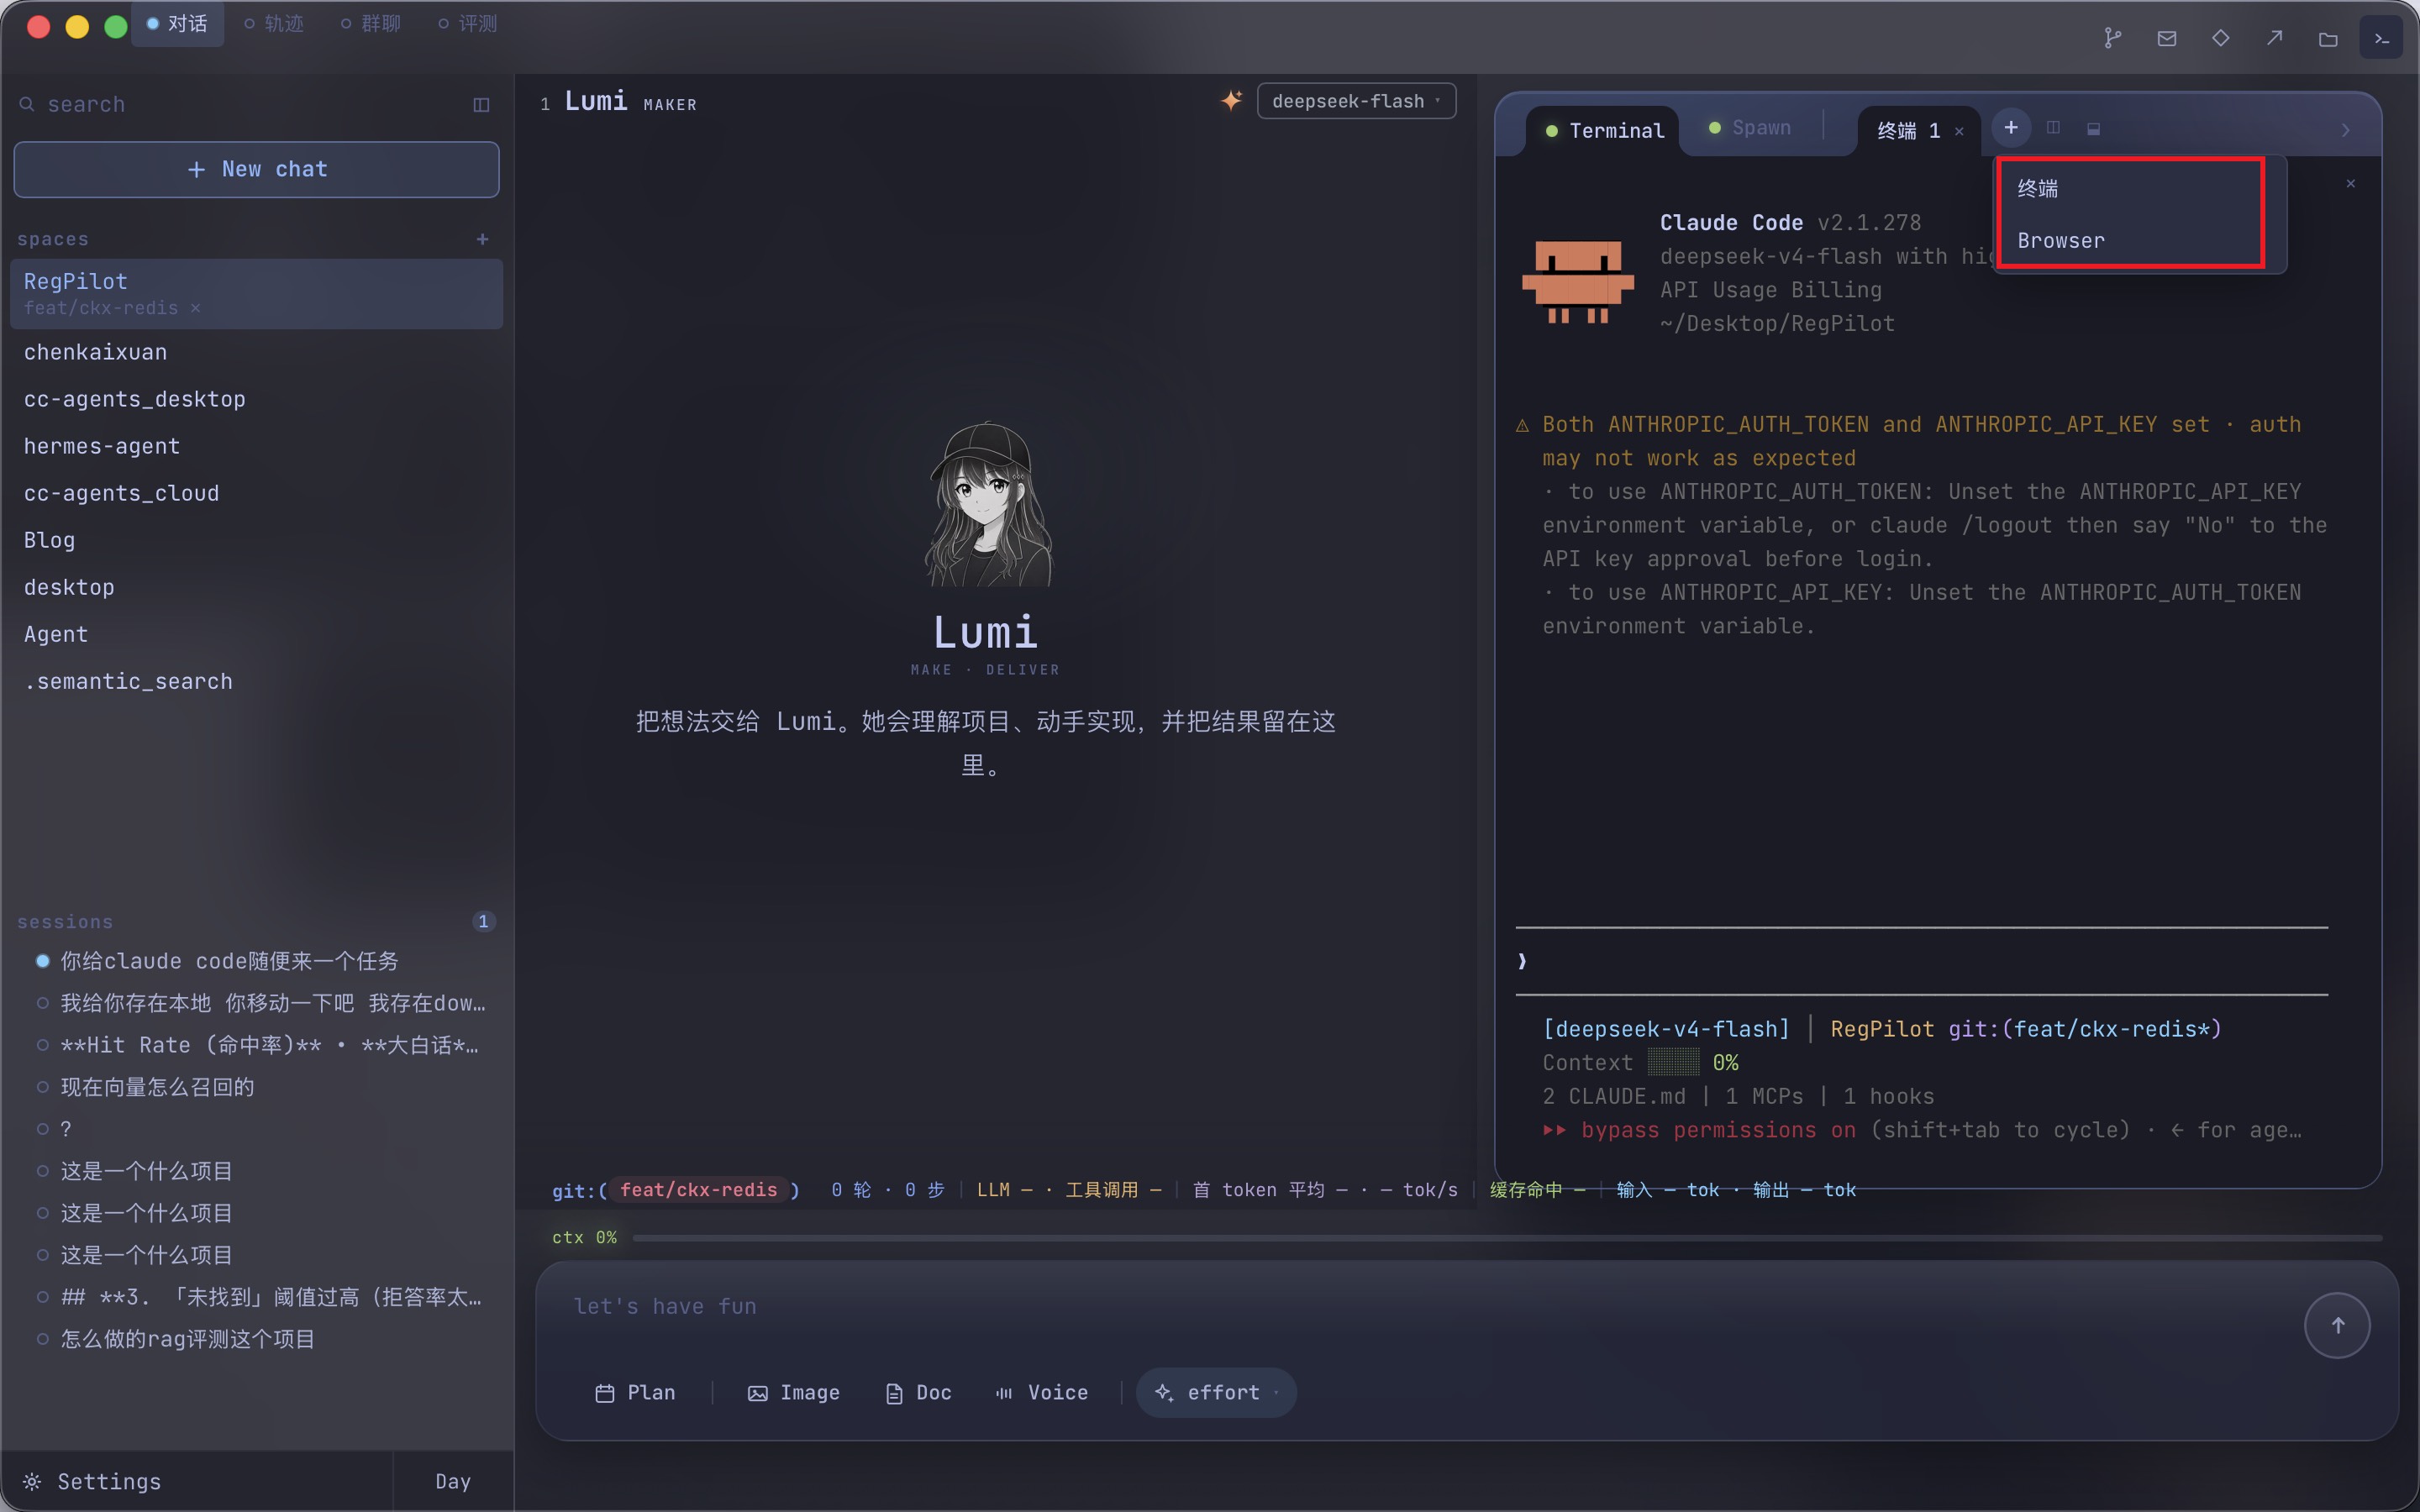
终端面板 — 「+」里开终端或 Browser;多标签,且终端归项目不归会话
Plan 模式下 Lumi 不猜。她会甩出一张提问卡:先把事实摆清楚,再列几个选项,每个选项后面跟着代价,还标出推荐哪个。回车选定,↑↓ 换选项。右栏顺手把结论落成待办清单,0/4 的进度一路跟着走。
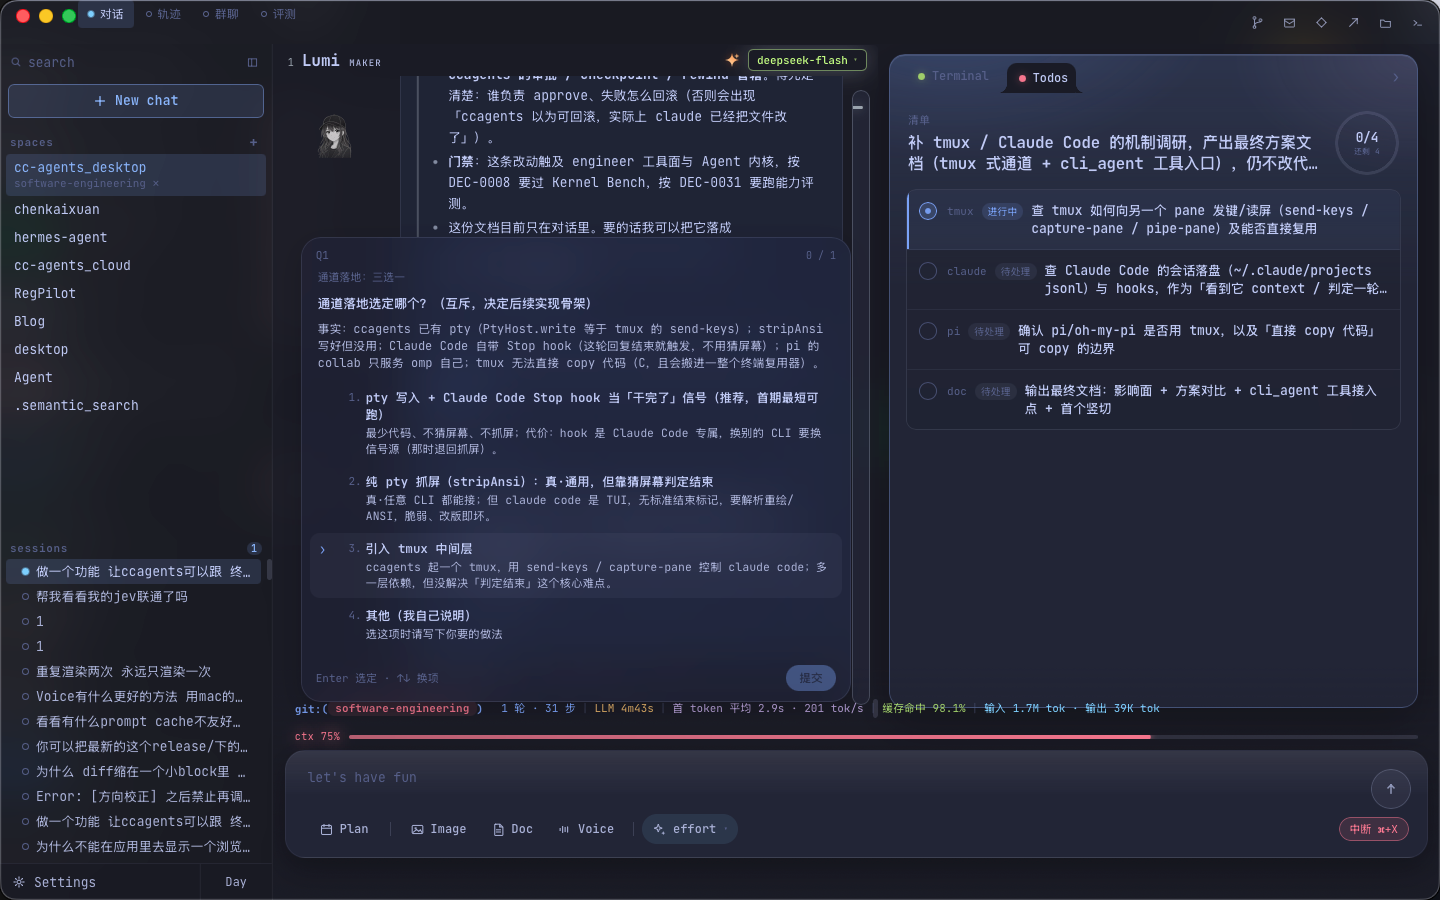
PLAN 模式 — 提问卡(选项 · 代价 · 推荐)+右栏待办清单
顶上写着 42 条 · 常驻 0,能按类型(用户 / 项目 / Agent)和状态(在用 / 暂不用 / 历史)筛。点开任意一条,右边是核心内容,下面「检索提示」写清它会不会参与全局检索、依据是什么。觉得不对,就地编辑、钉选常驻、移至暂不用,或者确认仍有效、直接删掉。
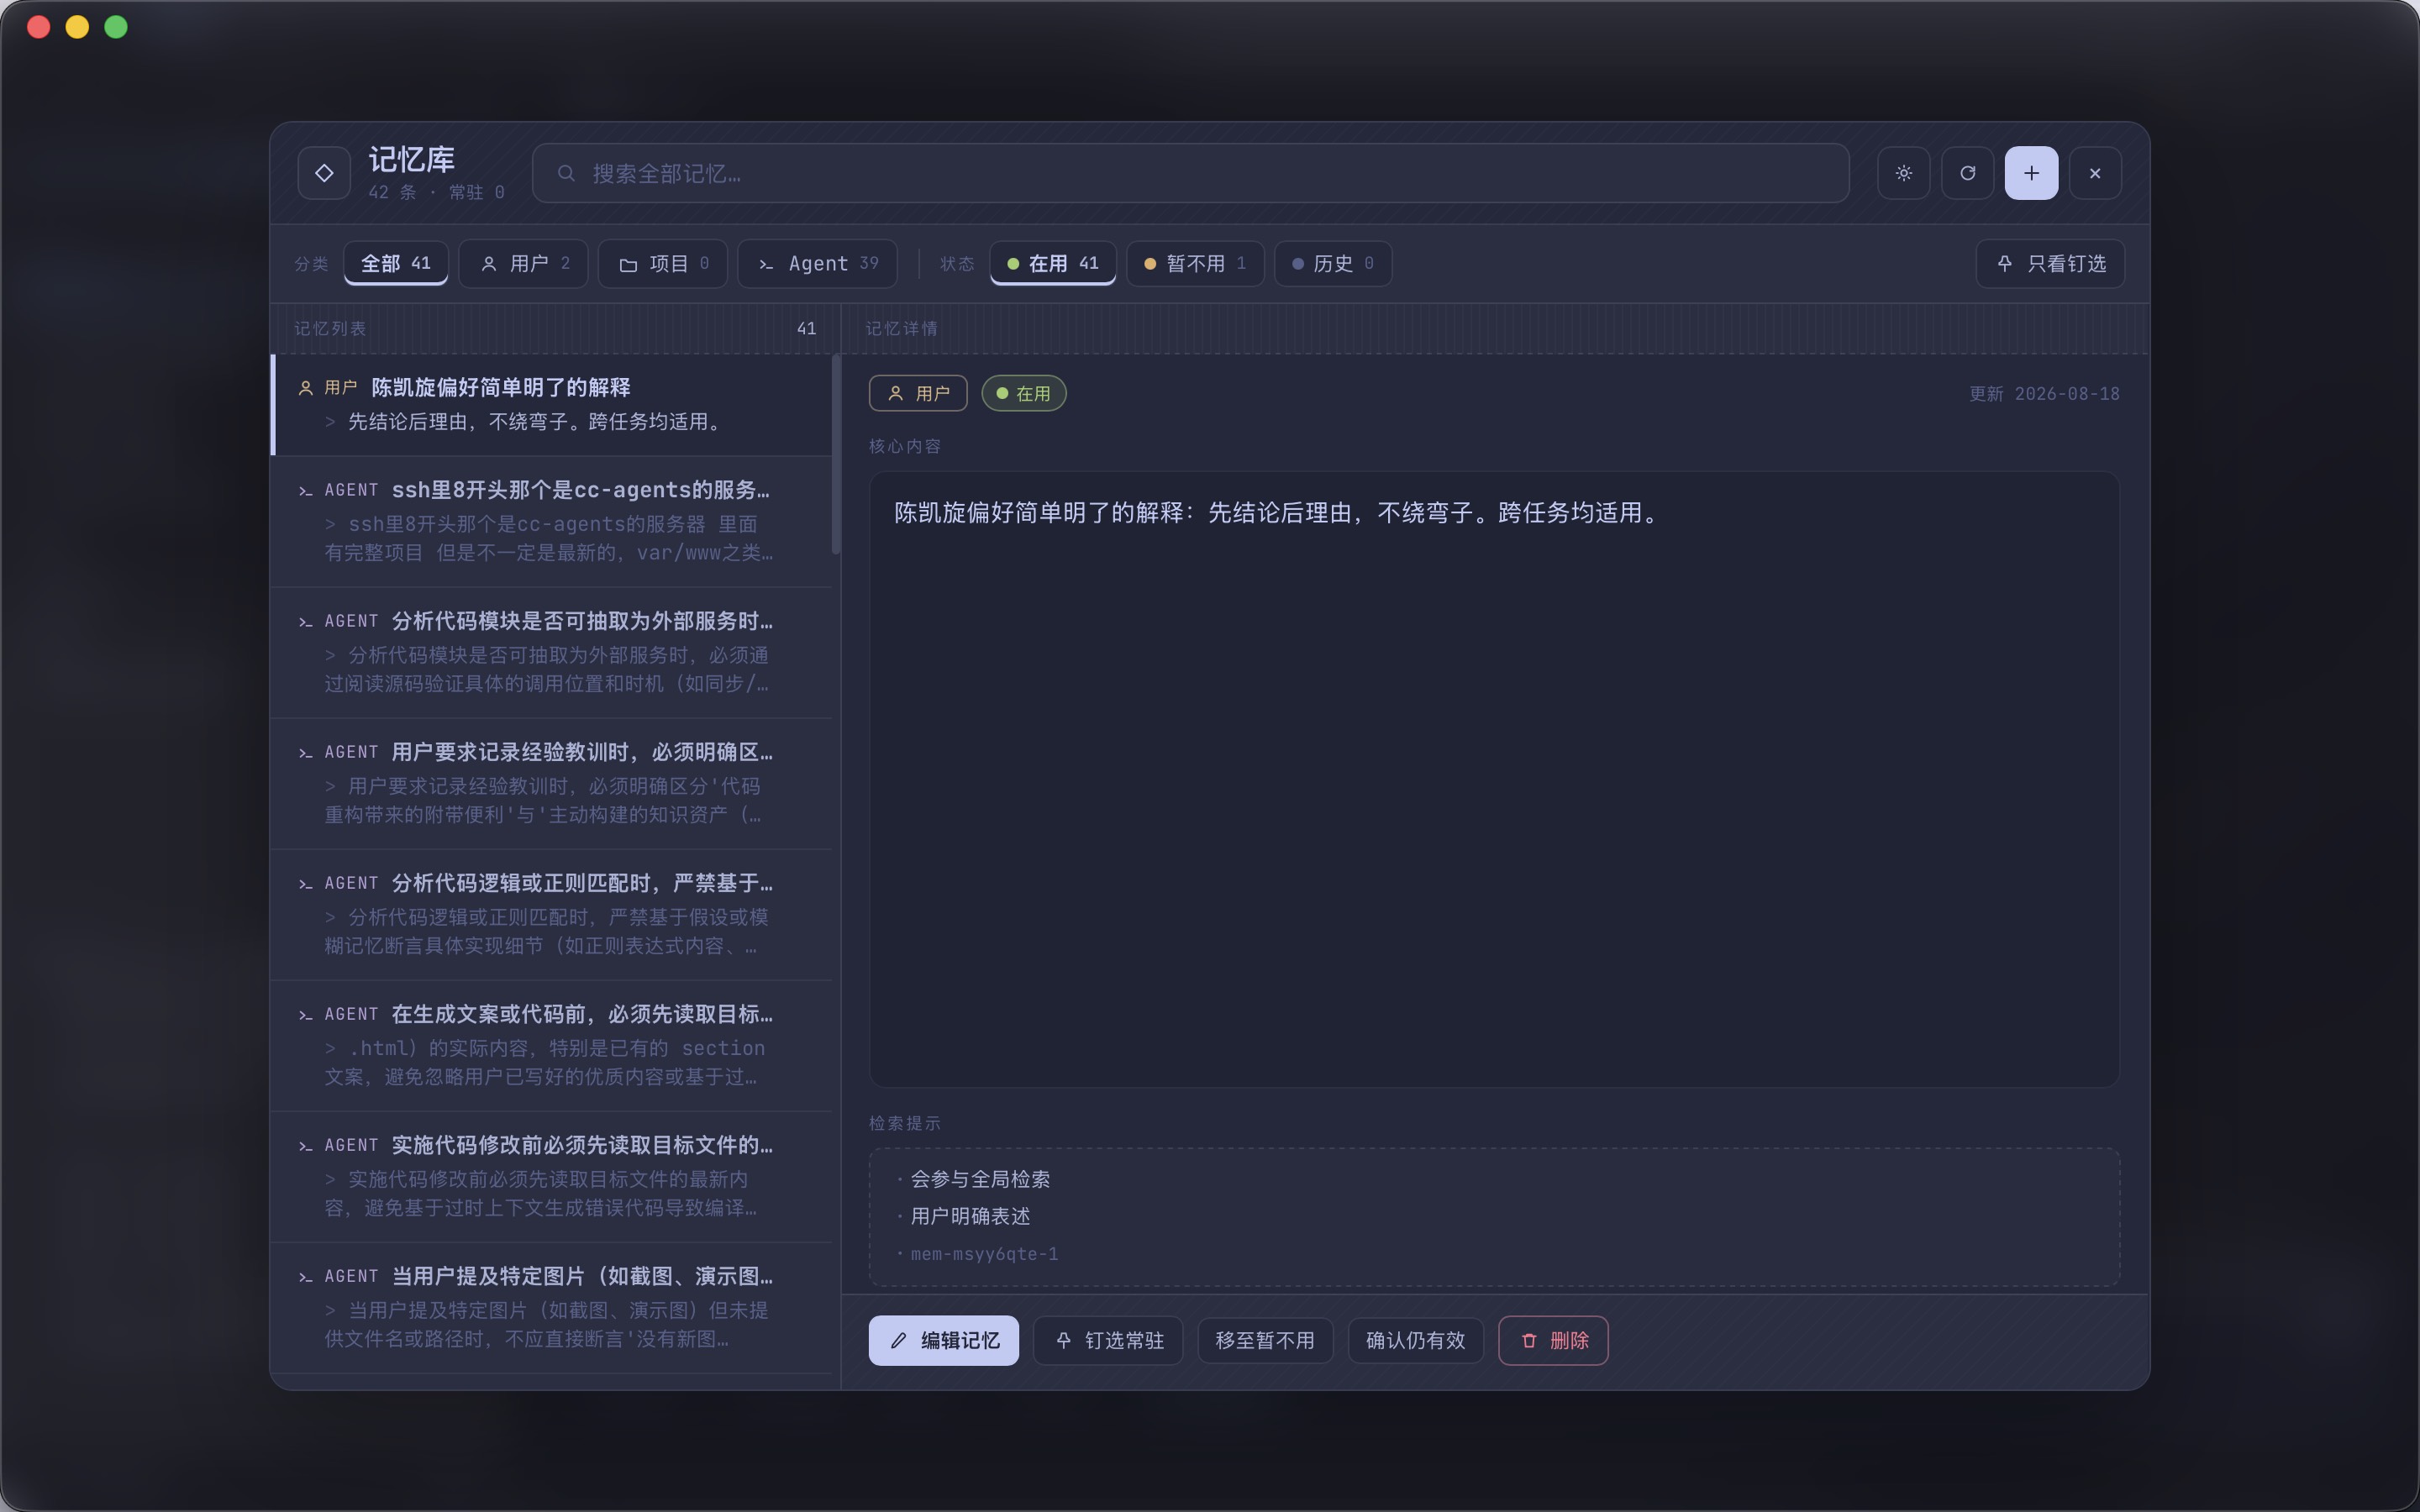
记忆库 — 42 条 · 按类型与状态分栏 · 详情写明检索依据
收件箱收的是 AI 主动发来的消息,右上角标着还有几条待处理——截图时是 0,所以整页空着:AI 还没有给你发消息呢。左边列消息,右边看详情,底下那句「查看详情不会消费消息」是给你的定心丸:点开不会消耗什么。
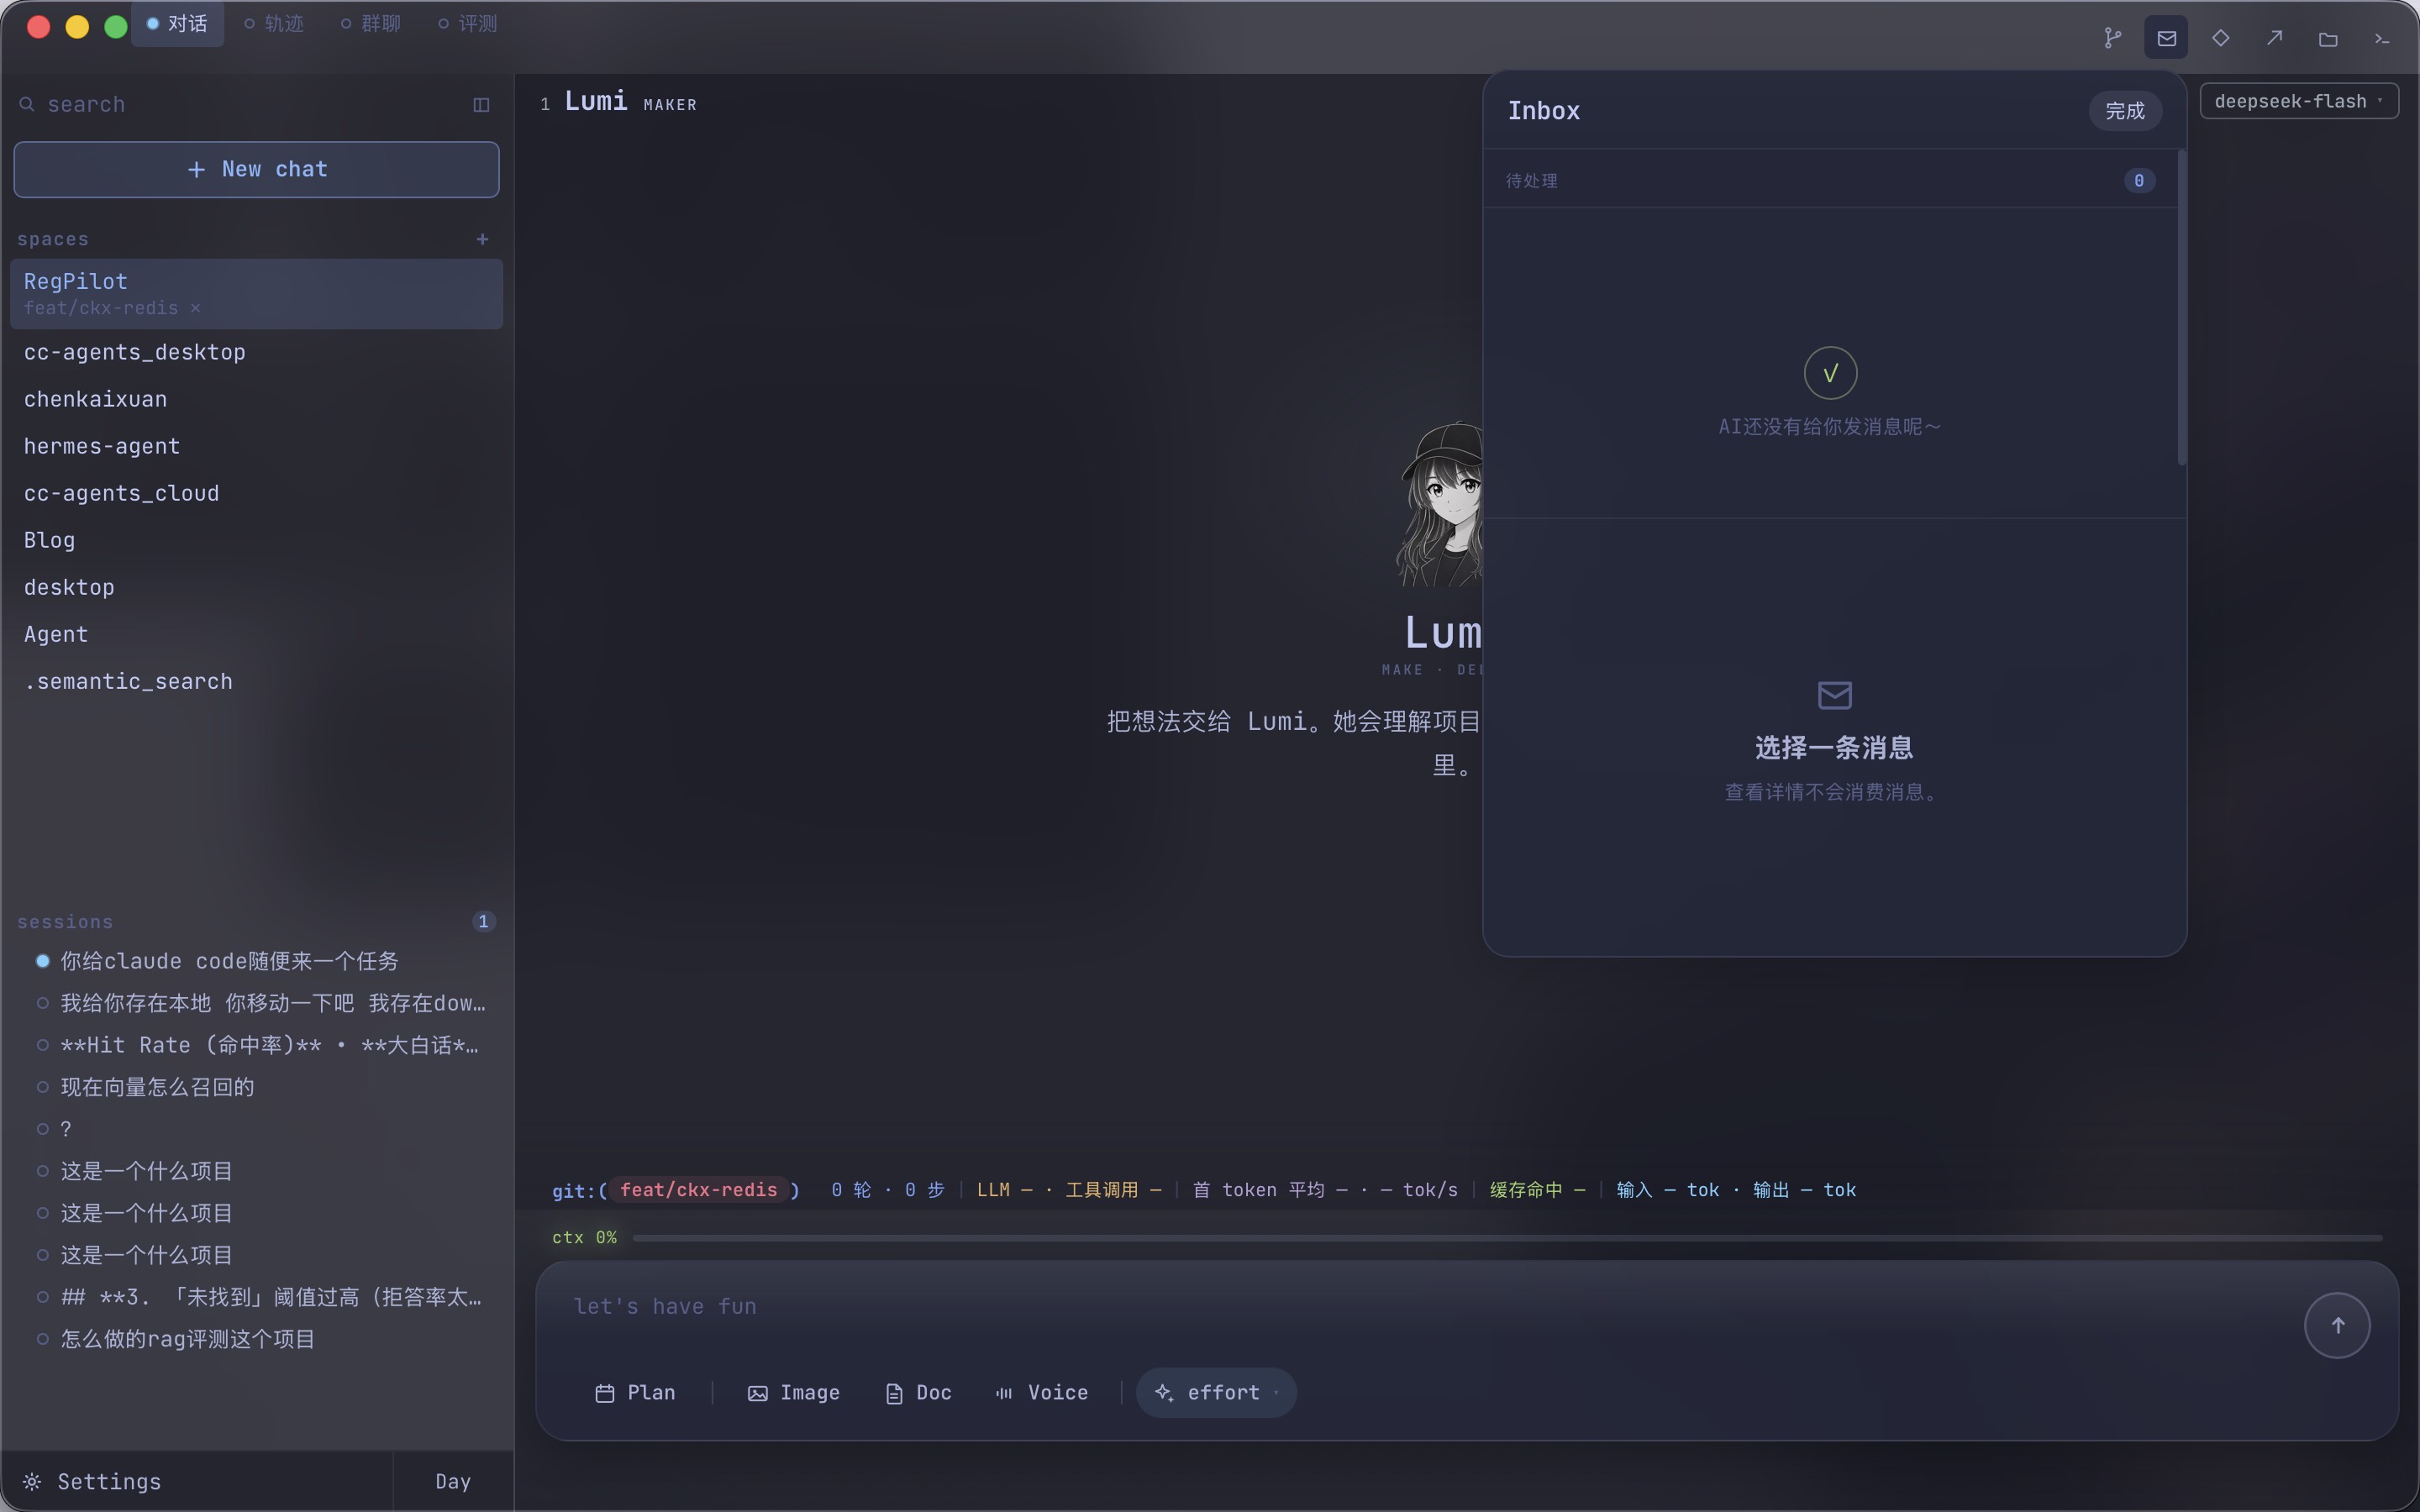
收件箱 — 待处理 0 的空态:AI 还没有给你发消息呢
Git 面板第一行就把分支说清楚:feat/ckx-redis → origin/feat/ckx-redis (dirty)。左边切仓库、翻 HISTORY,提交按 hash、标题、作者、时间排;右边是选中那次提交的 diff,+1 -1 直接标在文件名上,行级高亮。旁边那个 AI 页签,就是用来问「这次改动为什么这么写」的。
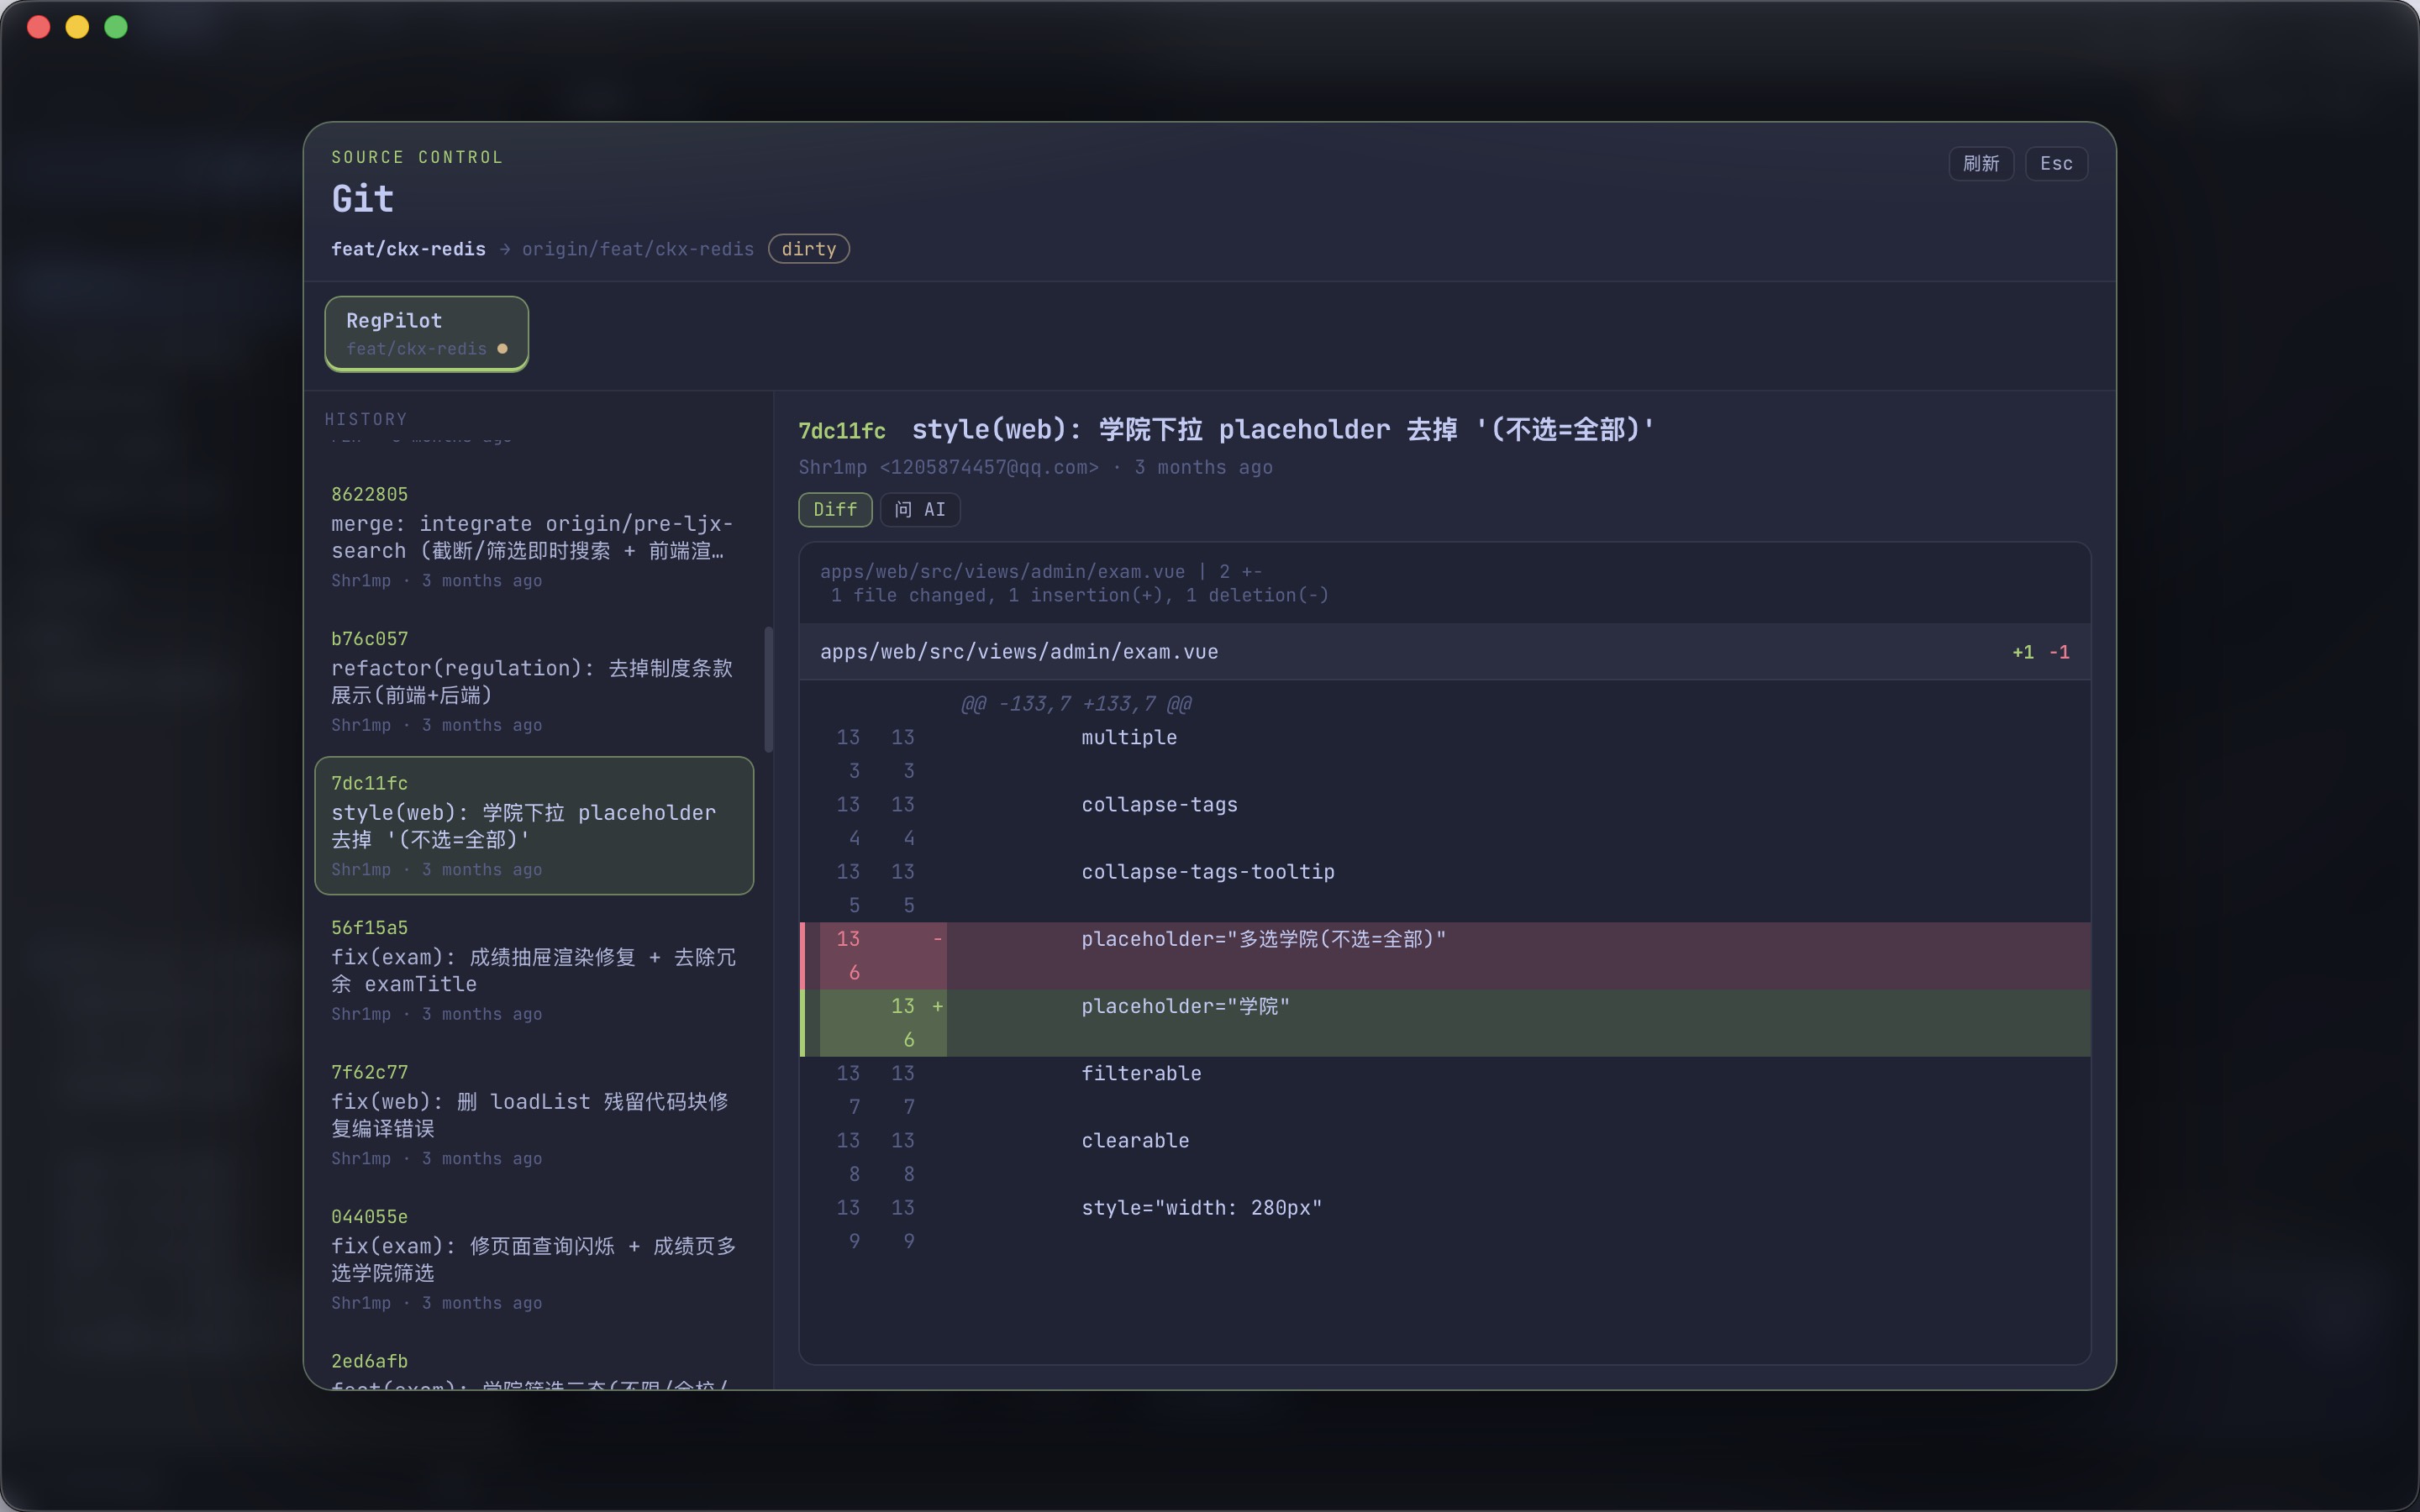
Git — 分支与远端 · 提交历史 · 行级 diff · AI 页签
两张卡:Lumi 一张,spawn_agent 子 agent 一张。API Key、模型名、provider、auth、max tokens、base URL 都能手填——截图里就是 openai 兼容的 opencode.ai zen 端点。子 agent 默认继承 Lumi 的模型和凭据,只改模型名。也能直接导入现成的 settings.json,落到全局 ~/.cc-agents/settings.json。
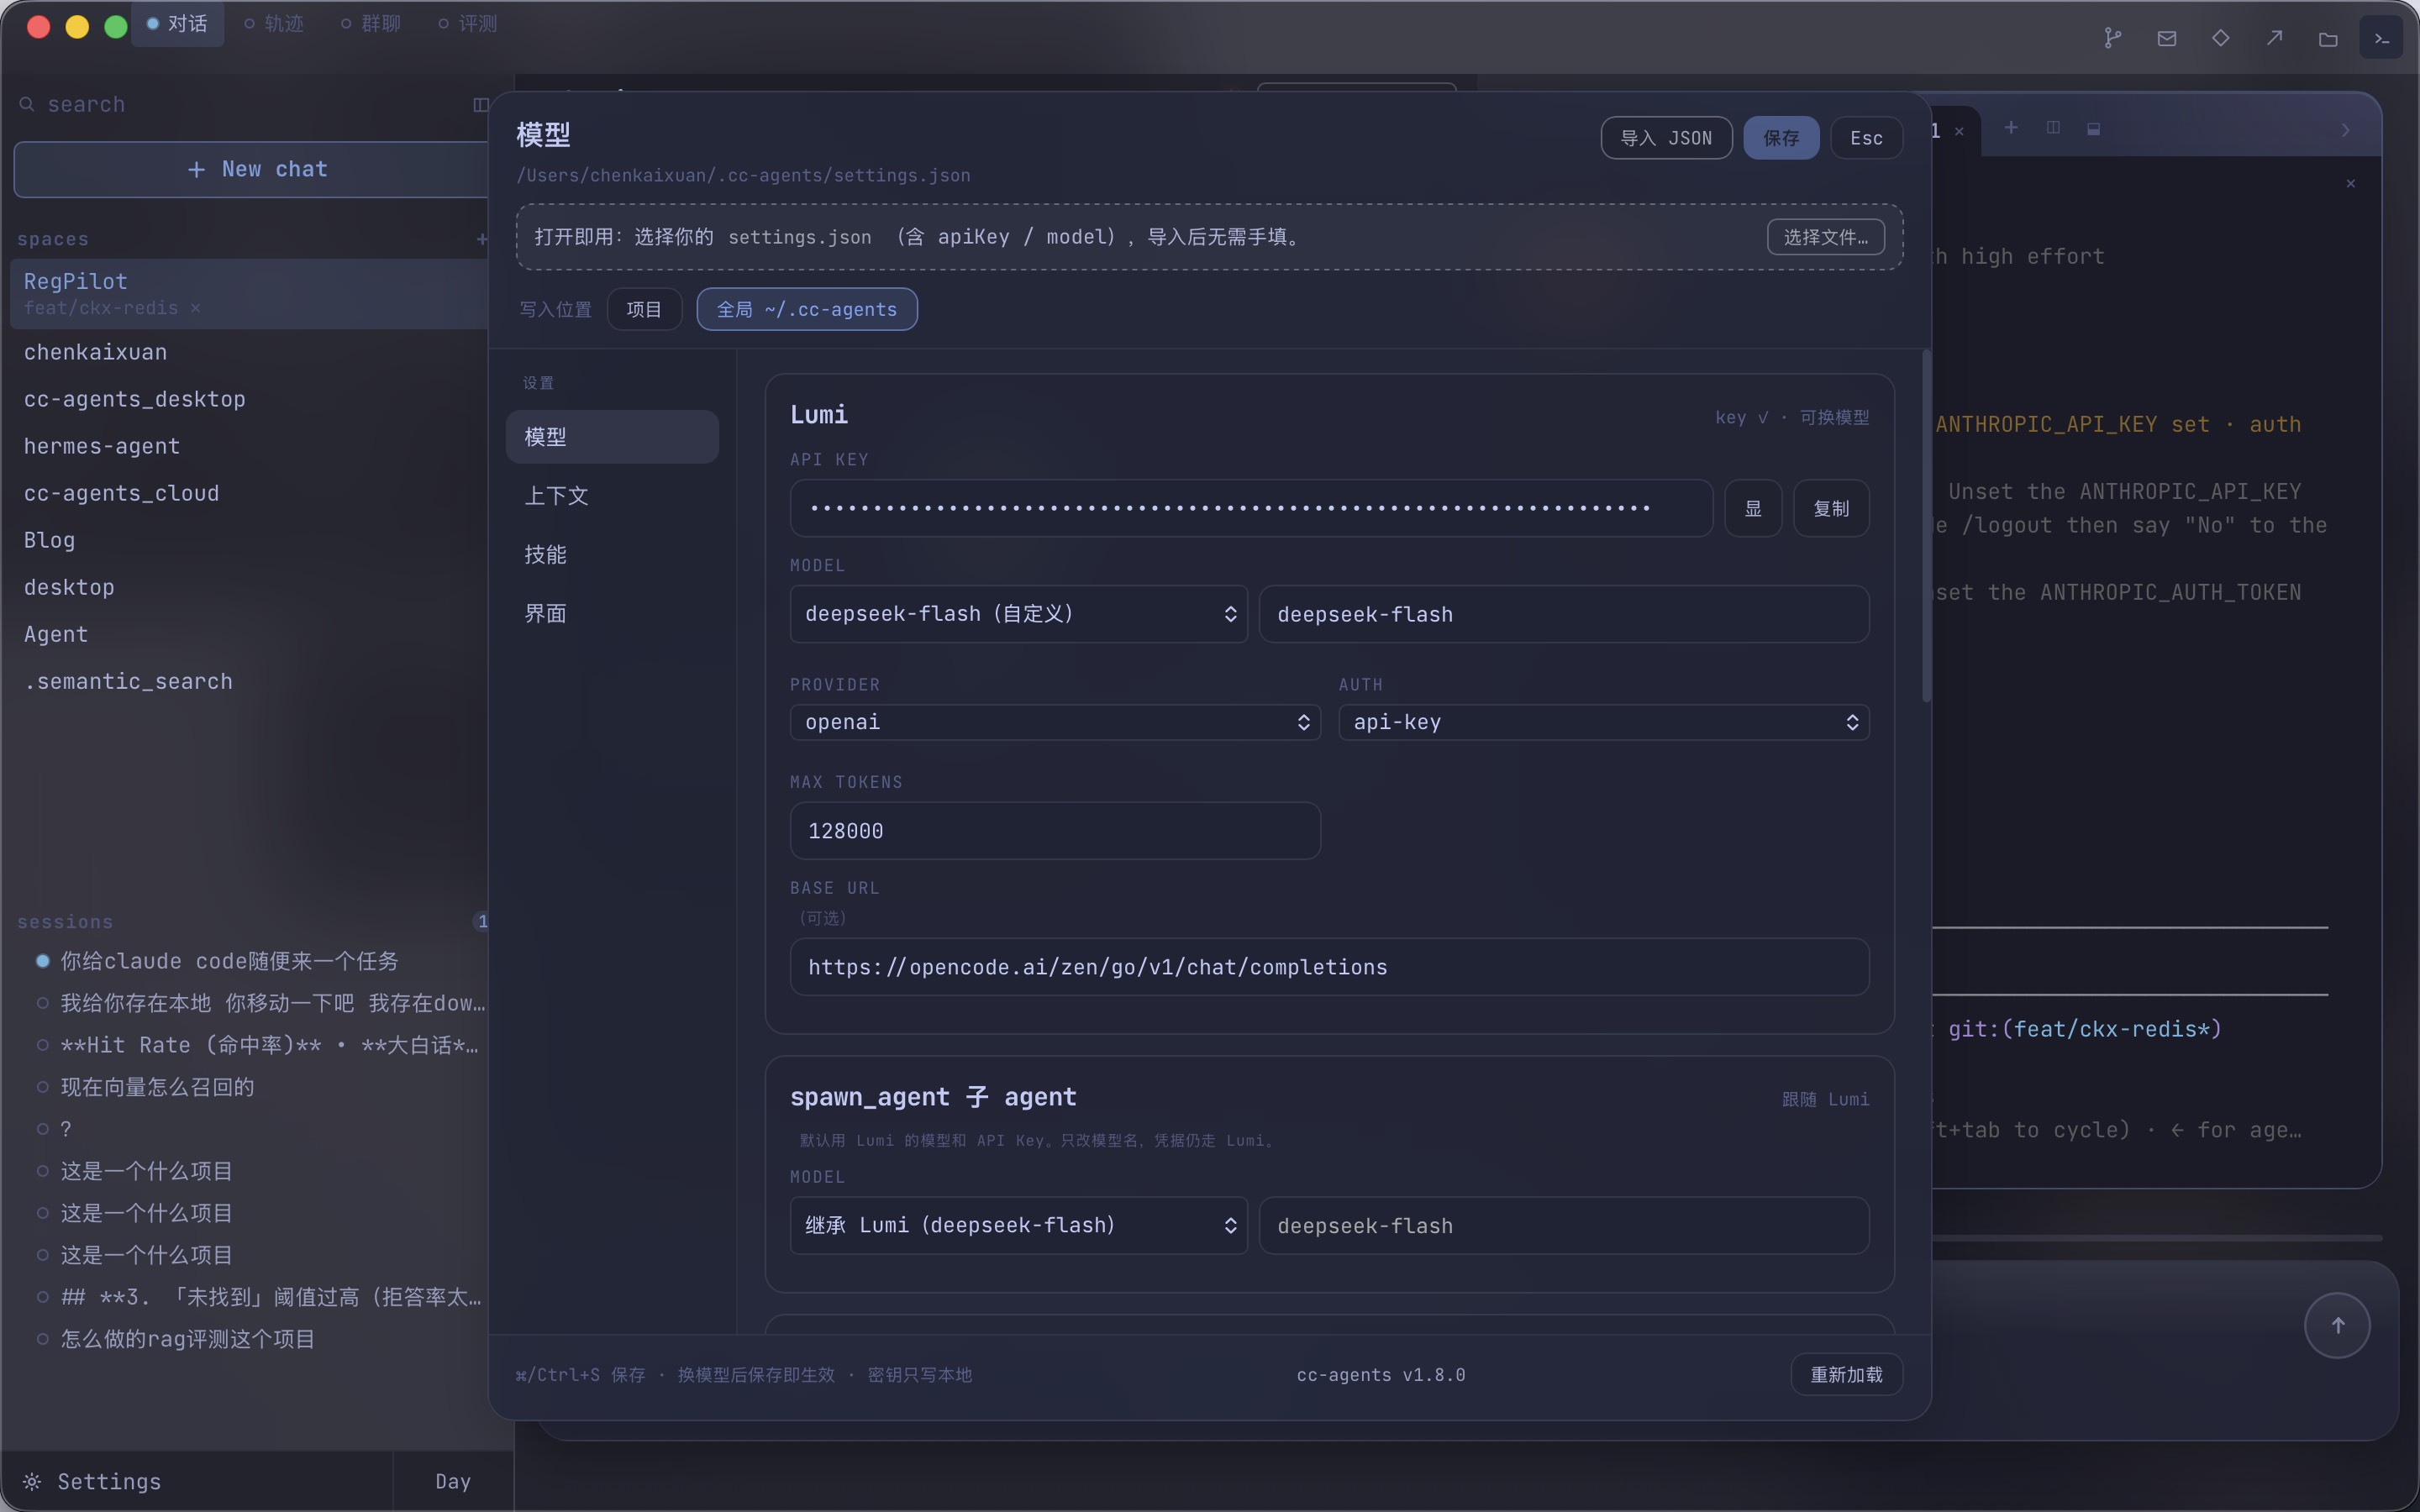
设置 · 模型 — Lumi 与 spawn_agent 各一张卡;密钥只写本地
这页管的是后台:并发会话数(默认 3,切会话不会打断后台工作);动态 Memory 检索——BM25 加本地向量,允许 Lumi 按需去翻没钉选的记忆;记忆整理——后台整理默认关着,得先去模型页开后台模型,卫生检查默认每 6 小时一次;还有云端记忆——选一个本机 SSH Host 连到远端 cc-agents-cloud,向量检索、网页搜索、文档解析走这条隧道,记忆分类和卫生检查仍留在本机。
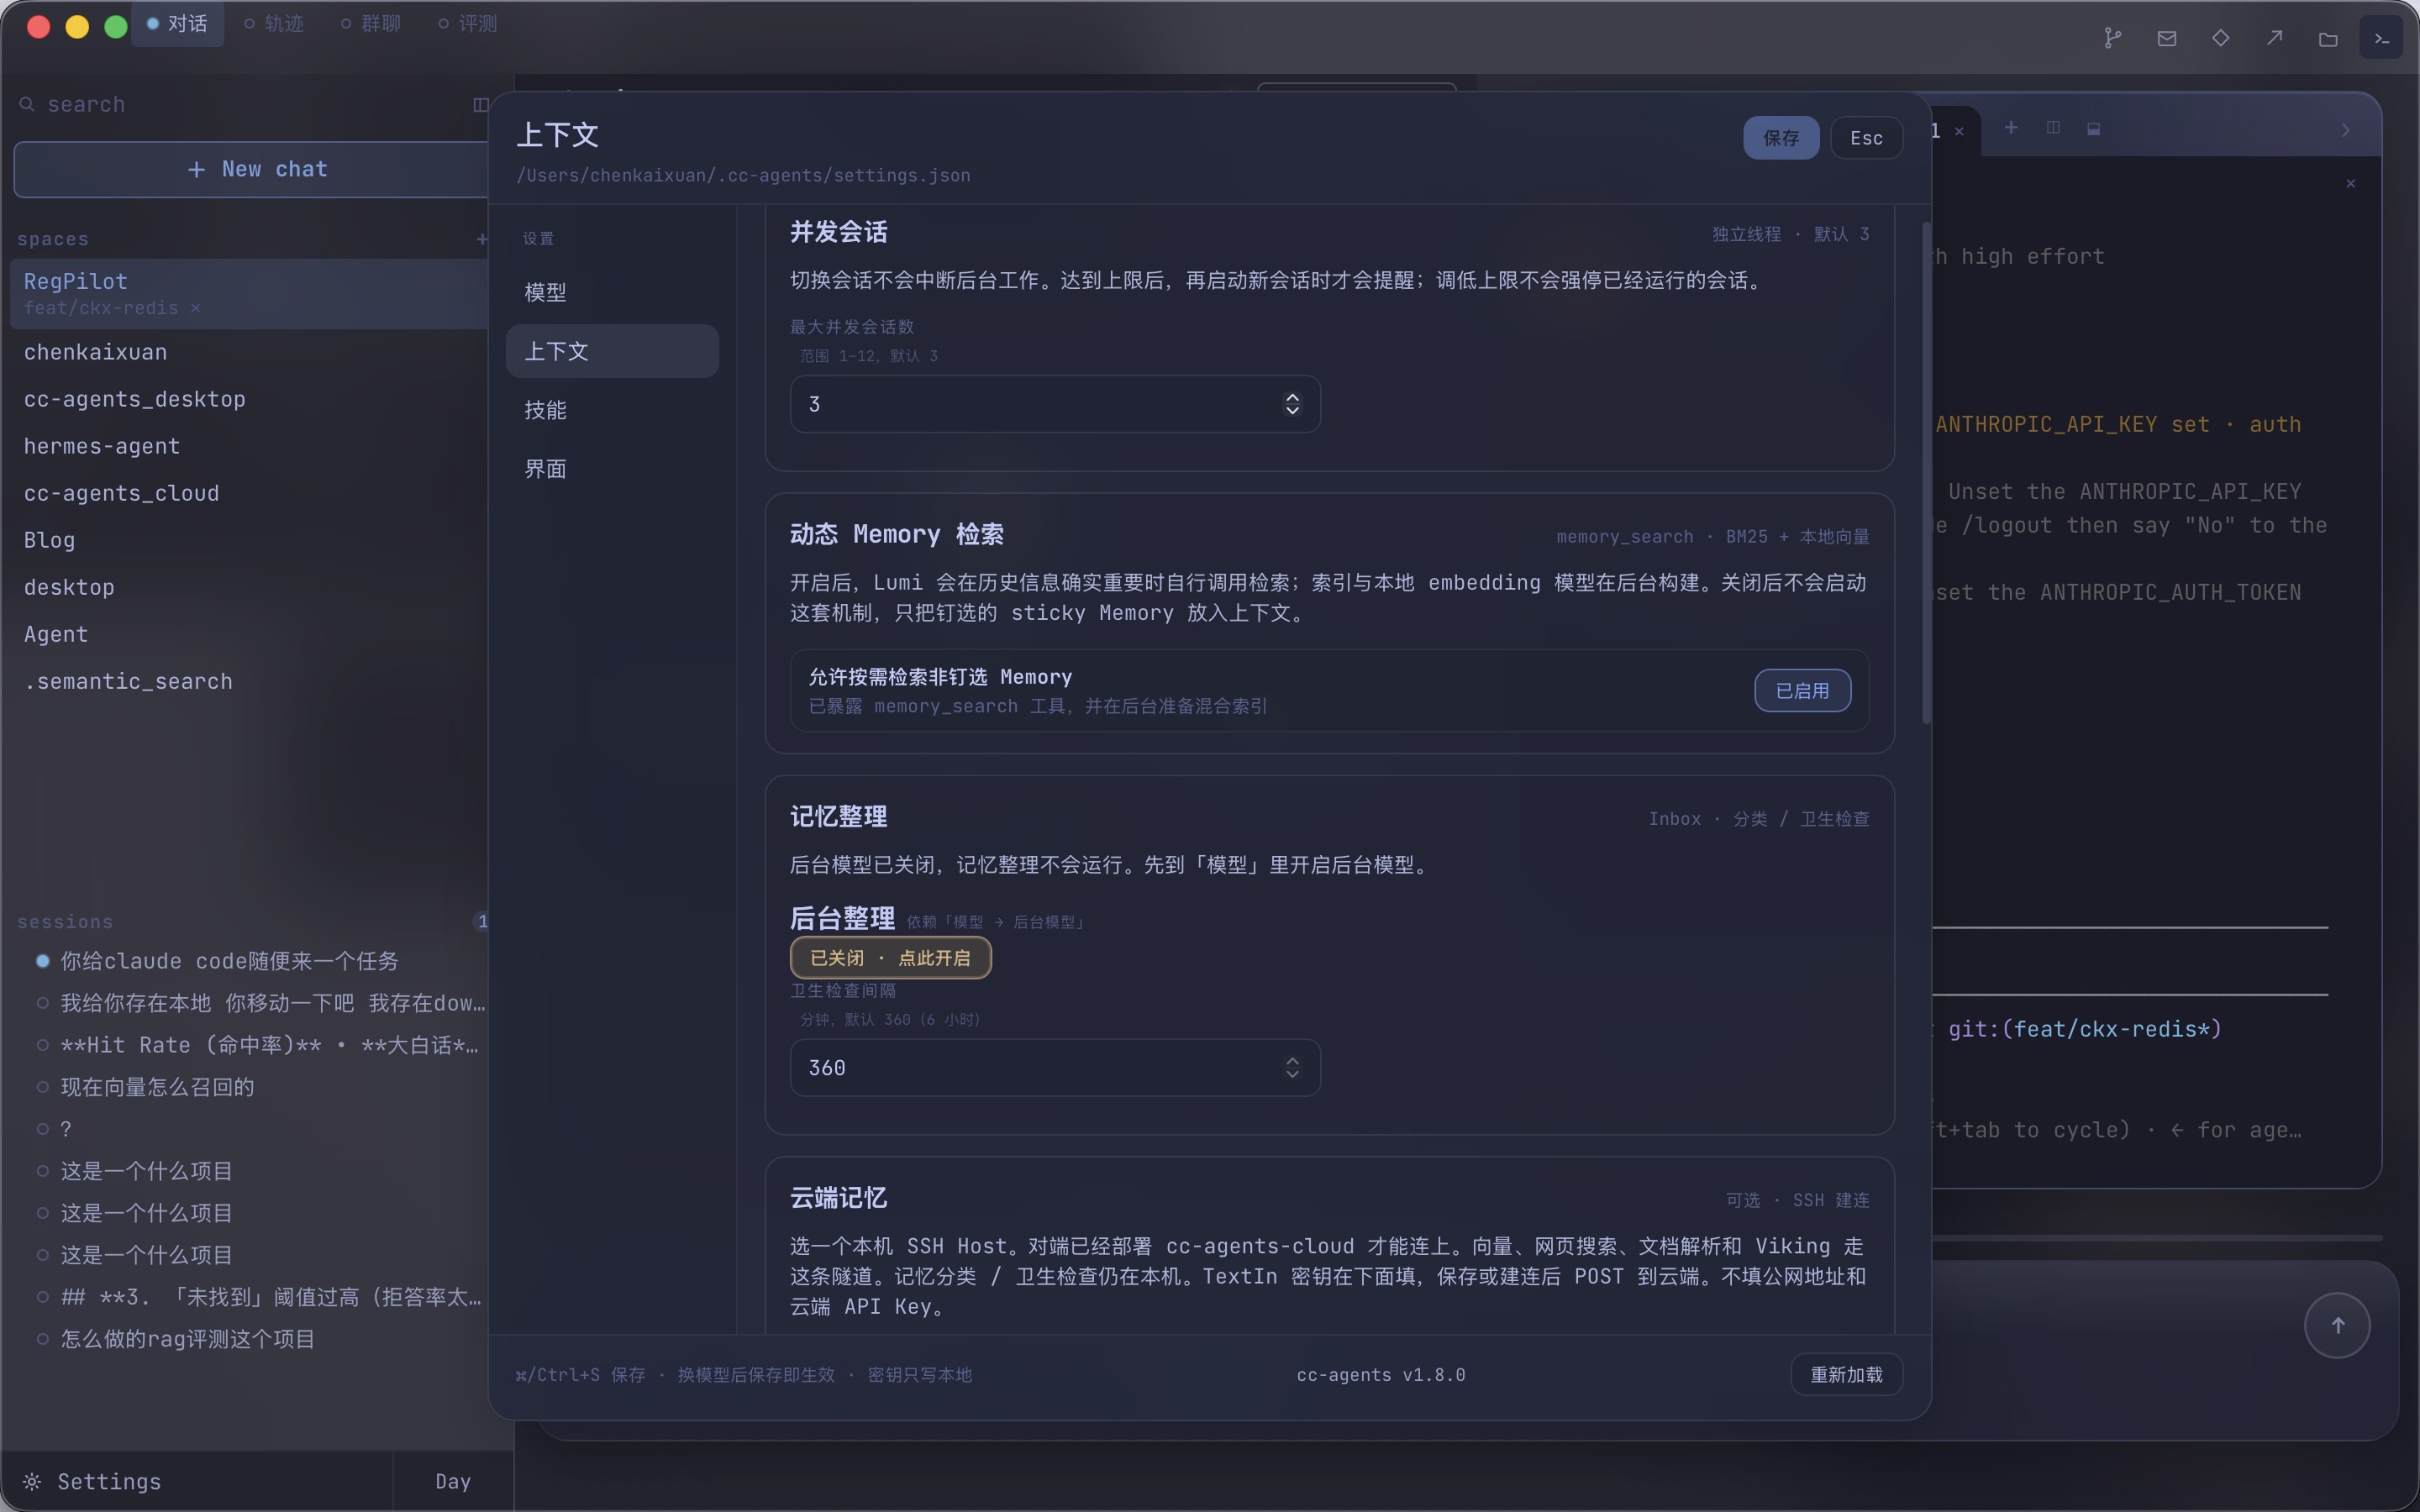
设置 · 上下文 — 并发会话 · 动态 Memory 检索 · 记忆整理 · 云端记忆(SSH)
评测页是一条九段的流水线:评测编排器 → 场景注入器 →(Runtime + Agent、全链路追踪)→(状态快照器、LLM-as-judge)→ 断言引擎 → 报告聚合器 → 综合结论。每个节点自己报状态,右栏是编排器的事件流。本机就能跑,顶上那行写着 npm run eval -- serve --local-sandbox。左栏管用例和历史 run,跑完生成报告。
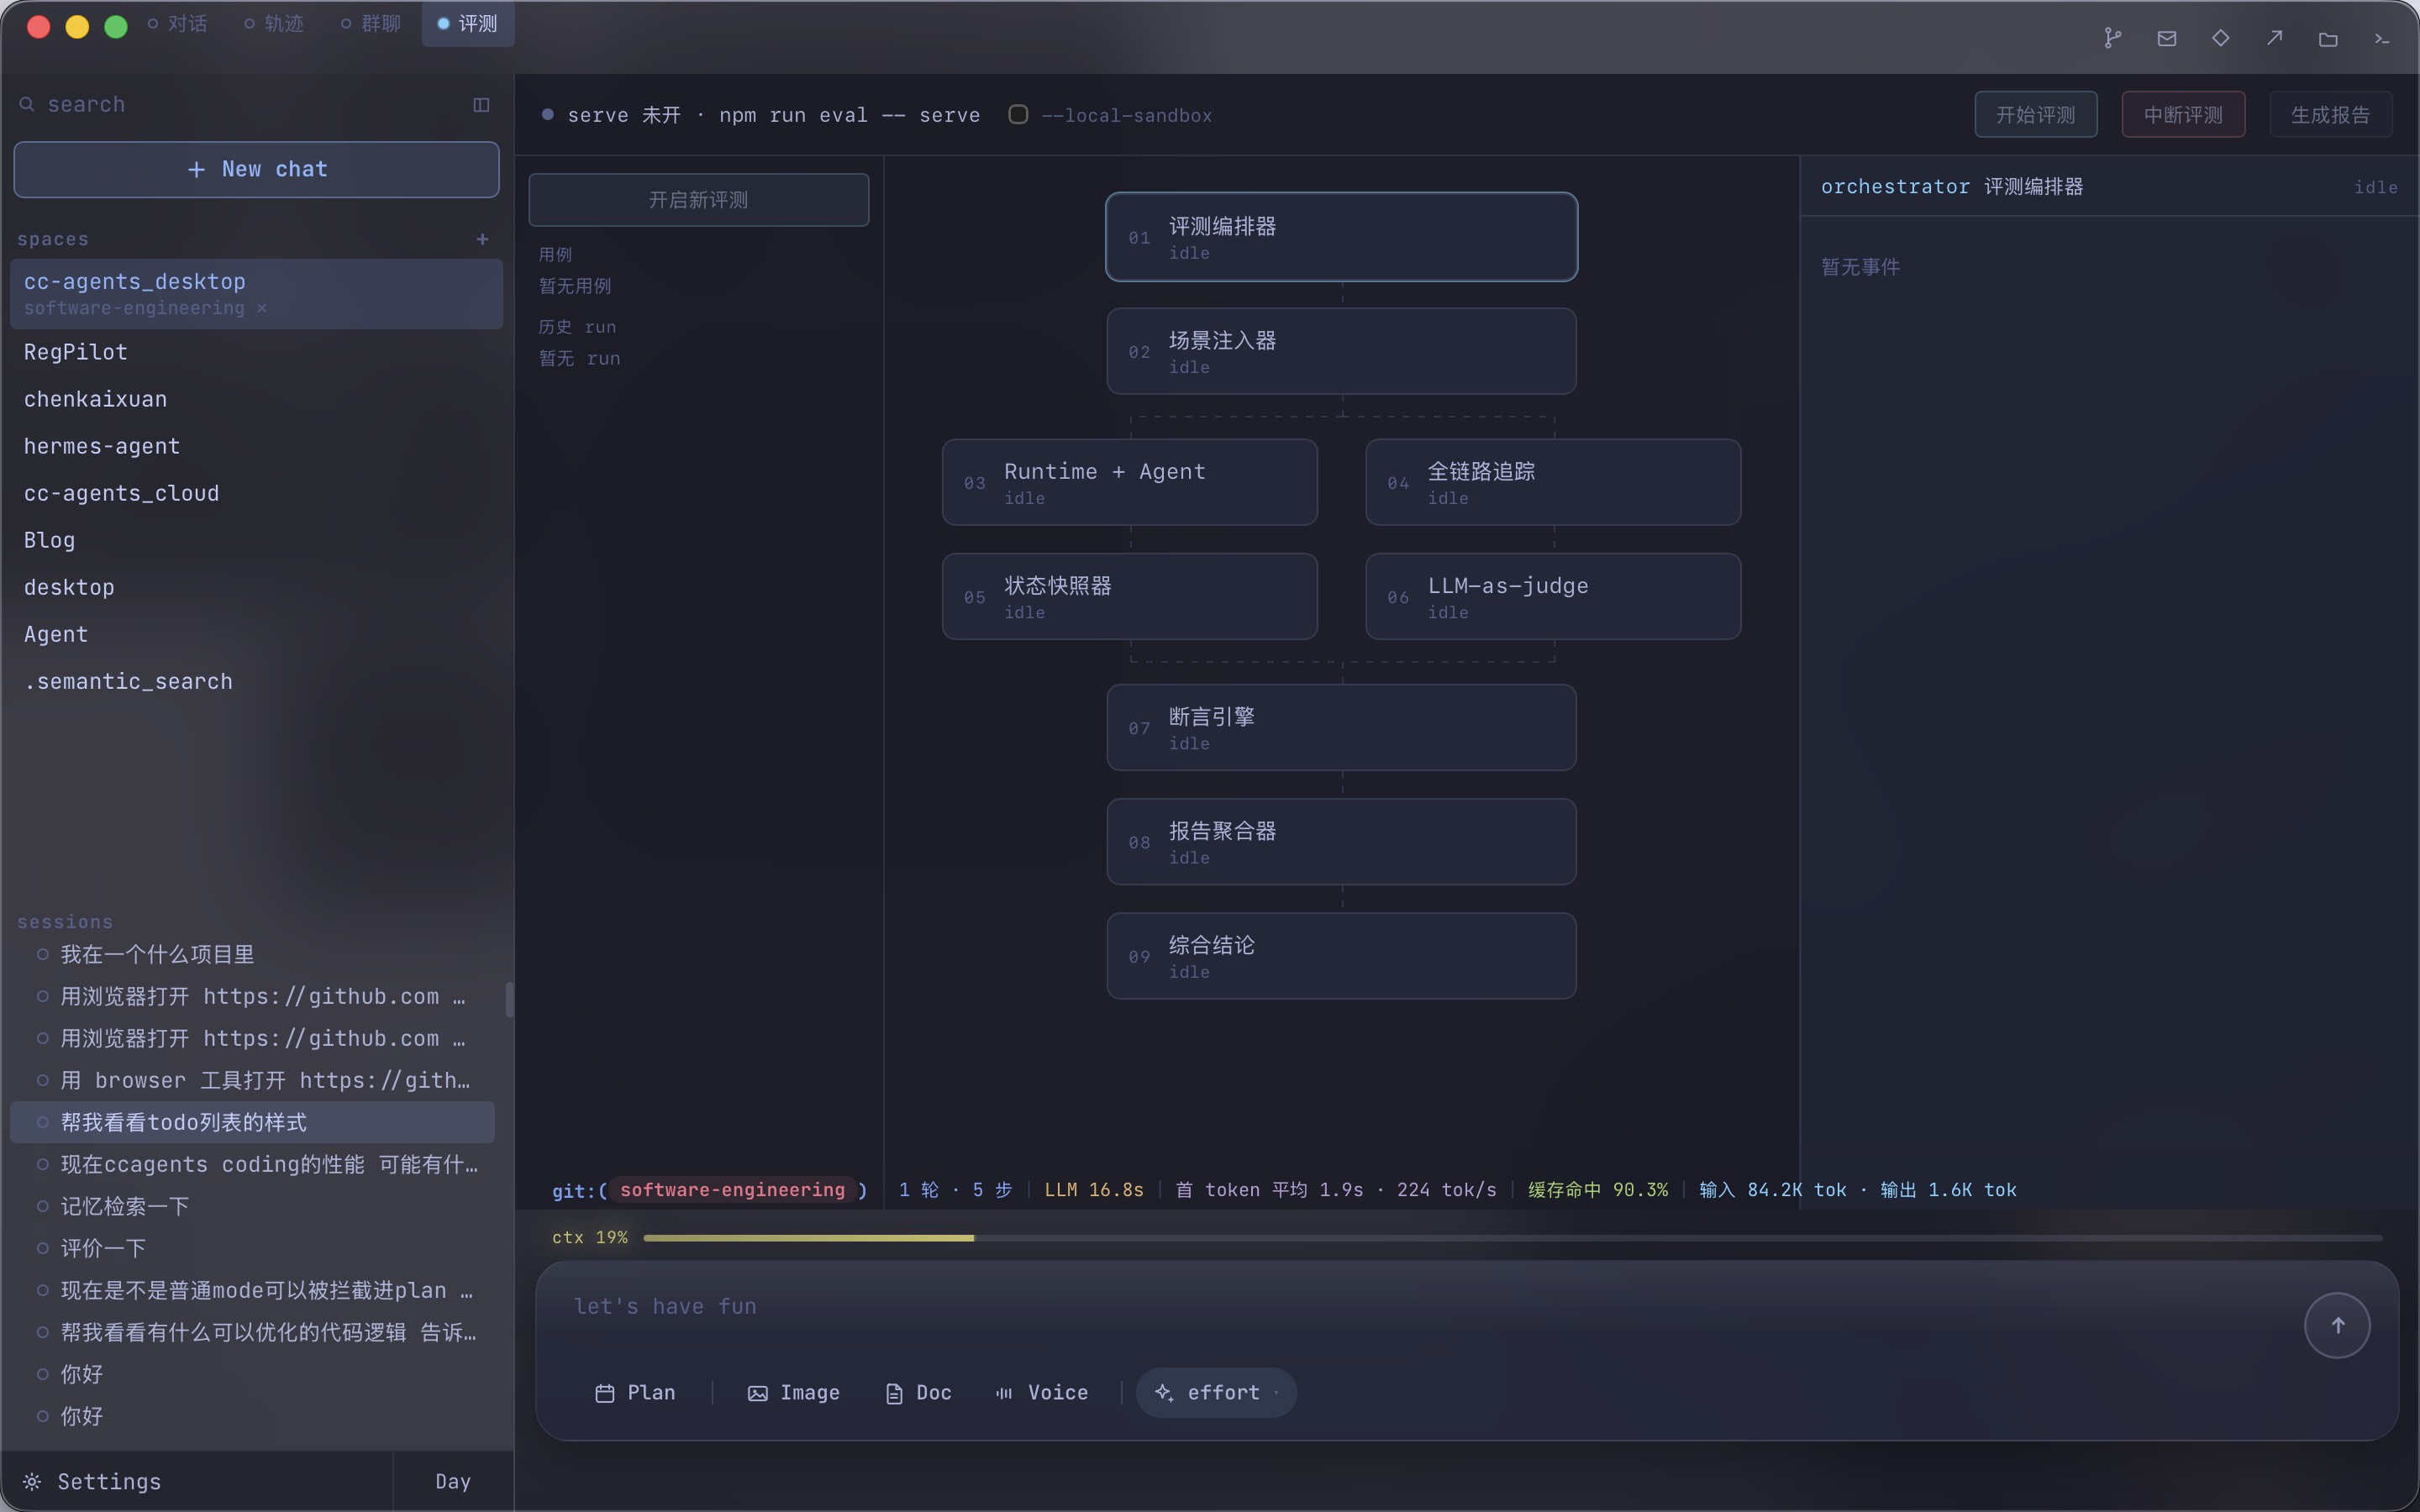
评测 — 九段节点从编排器到综合结论,截图时全在 idle
Lumi 判断某块实现边界清楚,就把任务派进右侧那个终端。中间层是 tmux——自建 socket(-L ccagents),不碰你自己的 tmux server;写入走 send-keys,读屏走 capture-pane。完成信号不靠猜屏幕:它给 Claude Code 注入一个 Stop hook(--settings 是合并,不是替换)去写 marker 文件,再读 hook 回给它的 transcript,只取最后一条 assistant 文本。
显示状态、任务原文、tmux 会话名和这一轮的产出;一个项目共用一个 tmux 会话。
点一下切到 Terminal 页,开出 tmux -L ccagents attach ——那就是个真 pane,你可以直接在里面打字。
设置里有 claude / claude-oc / claude-ds 三个预设;命令不对或没登录,pane 会自己退出,提示你去改。
默认 10 分钟超时,产出超过 8000 字取尾部;中间过程只在对话的工具结果里,卡片只画最近一轮。
CLAUDE CODE 协作 — 派过去 · 看终端 · 取回这一轮
设置里只填一个 SSH Host:从 ~/.ssh/config 扫出来挑,或者手填 host / user / port / IdentityFile,私钥不落地。桌面端用 BatchMode 连过去探 /health——必须回 service: cc-agents-cloud;再确认 /api/v1/link 的 handshake 是 ssh-tunnel,通了才建本地端口转发。不填公网地址,也不填云端 API Key,key 从对端 /opt/cc-agents-cloud/.env 里读。
没连云端也照样写代码:读改文件、终端、grep、代码库搜索、记忆分类和卫生检查都在本机,只有网页搜索和文档解析会不可用,记忆检索退成 BM25 关键词。
部署 — Docker 包装到 /opt/cc-agents-cloud(2GB 内存起);路径别改,客户端要读它的 .env,也别把 8080 开到公网
设置页里剩下的这些都不是装饰:后台模型是记忆分类、卫生检查、冲突检测的总闸(key 留空就用内置的);技能分三层加载,用到才取;压缩水位管的是「什么时候才值得压」。
记忆分类、卫生检查、冲突检测共用它。可选 gpt-4o-mini、claude-haiku-4-5、MiniMax-M2.5、deepseek-v4-flash;关掉会弹二次确认。
先只看到技能列表,要用才读它的 SOP,再需要才取脚本和参考——不整份塞进每一轮,轮末自动卸掉。内置技能只能开关不能删,自己的技能放项目的 .cc-agents/skills/。
输入到模型窗口的 82% 才开始判断要不要压;预计释放不到 40,000 tokens 就不压,免得白白重建 prompt cache。
中英双语、六种字体,Day / Night 在侧栏底部;打开 Tracker 会记录完整 I/O 与指标,本地 127.0.0.1:7778 就能看。
下载 macOS 安装包,拖进 Applications,就绪。
放到你的 Linux(2GB 即可)。解压后 sudo ./scripts/install.sh,再在 Desktop 里连上。
下载 cc-agents-cloud-docker.tgz需要 Node.js ≥ 22.19。标题栏出现 live 后再发消息。
设置页支持「打开即用」导入;也可手改 ~/.cc-agents/settings.json。
还在用终端 TUI? → CLI 介绍页